
生产环境问题排查:从告警到根因
从两级 RPC 告警入手,沿指标、日志、Trace 和代码定位问题,并通过 Kitex 与 Kubernetes 实验分析发布、摘流、扩容和负载均衡。
目录
引子:值班时突然收到两封告警
想象一下,你正在值班,手头的事情刚告一段落,收件箱里突然多了一封告警邮件:[FIRING][P2][WARNING],Zone A 的 Kitex RPC 开始超时。
你还没来得及打开监控,第二封邮件又到了:[FIRING][P1][CRITICAL]。同一个 Zone 的超时比例持续超过阈值,告警等级也升高了。
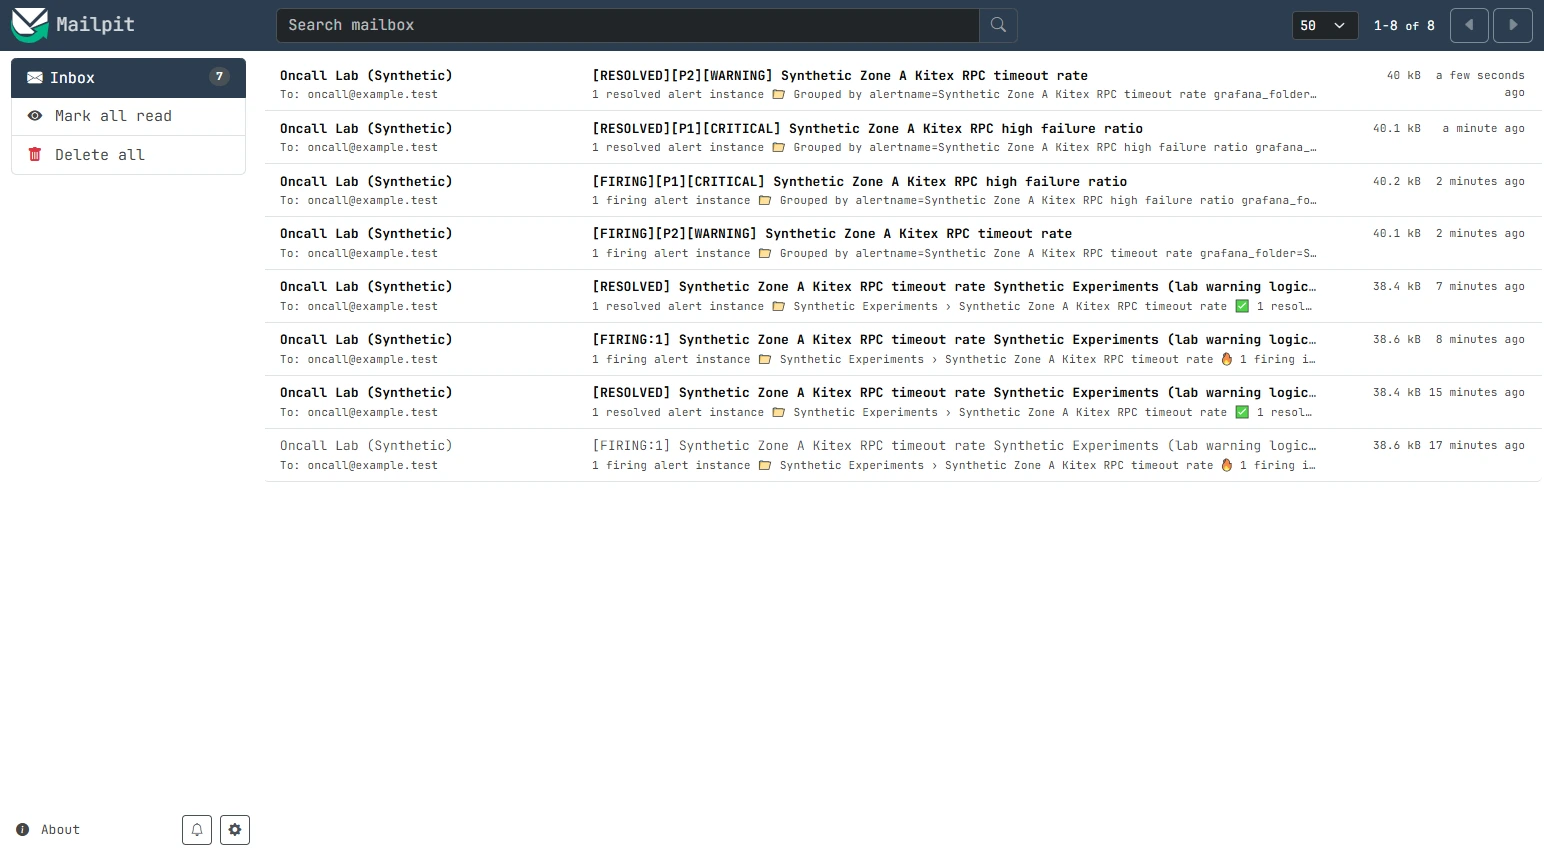
现在轮到你处理了。你知道有 RPC 请求失败,却不知道影响了多少请求;知道错误集中在 Zone A,却不知道是某台实例出了问题,还是整个调用链出了问题。更麻烦的是,RPC 超时只告诉你调用方没等到结果,并没有告诉你时间究竟耗在了哪里。
是刚刚发布导致的?是流量突然上涨?还是下游处理太慢,或者连接本身出了问题?
这时候与其凭经验猜原因,不如先确定该看哪些指标、怎样缩小范围、什么时候可以下结论。
0. 实验环境与复现
我们搭建了一套本地实验环境,用来模拟开篇的 RPC 超时。整个系统分为三个逻辑 Zone,每个 Zone 运行两组 Gateway 和 Metadata,服务之间通过 Kitex/Thrift RPC 通信。
实验分为三个阶段:先发送正常请求,再让 Zone A 的部分请求在 Metadata 端延迟 1500ms,超过 Gateway 设置的 1200ms RPC 超时预算,最后停止注入,观察请求是否恢复。
Prometheus 采集指标,Loki 收集日志,Tempo 记录调用链,Grafana 根据超时指标触发 P1/P2 告警,再将通知发送到本地 Mailpit 收件箱。实验架构如下:
Load Generator(合成请求)
    |
    +-- Zone A:Gateway A1/A2 --> Kitex Metadata A1/A2
    +-- Zone B:Gateway B1/B2 --> Kitex Metadata B1/B2
    +-- Zone C:Gateway C1/C2 --> Kitex Metadata C1/C2
                  |
                  +-- Kitex 原生指标 / 应用指标 --> Prometheus
                  +-- JSON 日志 ----------------> Promtail --> Loki
                  +-- OpenTelemetry Trace ------> Tempo
                                                        |
                  Grafana Dashboard / Explore <---------+
                  Grafana Alerting --> 本地 SMTP --> Mailpit
这里的三个 Zone 是同一台电脑上的 Docker 逻辑故障域。告警邮件进入本地 Mailpit。发布、扩容和摘流部分则使用 Kind 集群;两套环境都运行在同一宿主机上。
亲手复现这次告警
实验代码:oncall-lab。运行下面几条命令,就能复现刚才收到的告警。安装、配置和清理步骤详见 中文 README 和 English README。
准备 Git、Docker Compose、Bash、Python 3 和 curl,确保 Docker 已启动;Windows 建议使用 WSL2 + Docker Desktop。主实验无需在宿主机安装 Go。
git clone https://github.com/ThinkerQAQ/oncall-lab.git
cd oncall-lab
cp .env.example .env

# 编辑 .env,把 GRAFANA_ADMIN_PASSWORD 改为自己的本地密码
bash scripts/scenarios/replay-alert-notification.sh脚本构建并启动服务,依次运行正常基线 → Zone A 超时注入 → 恢复,并检查请求结果和 P1/P2 的触发、恢复邮件。
完成之后,先去 Mailpit 看看自己是否也收到了开篇的两级告警,再打开 Grafana 查看请求量、超时率、日志和 Trace。Grafana Explore 需要用 demo 和 .env 中设置的密码登录。
每次运行的请求数量可能略有差异。验收时重点检查三个结果:超时是否集中在 Zone A、故障结束后是否恢复、P1/P2 通知是否正常送达。
1. 对生产环境问题排查的理解
下面进入正文,先说说我对生产环境问题排查的理解。
线上系统每天都会发生异常:成功率下降、请求超时、实例重启、资源使用率上涨。不是每条异常都意味着生产事故,但如果完全不处理,就可能发展成真正的稳定性问题。
因此需要有人负责响应和推进。这里的“负责”不等于独自解决全部问题。On-call Owner 更常扮演异常事件的接口人:理解影响范围,找到对应的负责人,推进止损、恢复和后续复盘。
遇到告警时,最容易犯的错误是直接去看某条代码,或者看到一个熟悉的错误就猜测根因。更合理的顺序是先弄清楚这条告警到底表达了什么,再用证据不断排除不成立的解释。
排查可以按七个步骤展开:
- 分清轻重缓急:先决定是否需要立即处理。
- 响应异常:明确已经有人接手。
- 理解异常上下文:什么时候、哪里、发生了什么,正常情况怎样。
- 分析异常:查变更、整体监控、指标下钻、日志与 Trace、代码。
- 给出结论:区分观察现象、失败机制和仍未确认的根因。
- 推进问题解决:止损、联系负责人、验证恢复。
- 总结并沉淀文档:留下下一次可以复用的分析思路。
这七步不是每次都必须机械地走完。一个明显由刚发布代码引起的严重故障,可以先回滚,再继续分析;一个短暂且影响有限的波动,也可能只需要核对和记录。
2. 如何排查:从收到告警开始
2.1 一、分清轻重缓急
先看两封邮件:P2/Warning 提示 Zone A 出现超时,P1/Critical 则说明超时比例已经超过更高的阈值。收到两条告警时,应该先判断影响范围和处理优先级。
有些团队会按如下三个维度决定事件处理顺序:
| 维度 | 示例排序 | 要回答的问题 |
|---|---|---|
| 事件优先级 | P0 > P1 > P2 | 对业务有多大影响,需要多快介入? |
| 通知方式 | 电话 > 即时消息 > 普通邮件 | 要求多快让值班人员注意到? |
| 告警严重程度 | Critical > Warning | 当前指标是否超过预设的严重程度门槛? |
它们不是同一套枚举。 Critical 是告警规则的严重程度,P1 是这次事件的处置优先级;不能从 severity=critical 自动推出“已经发生 P0 事故”。通知渠道也不直接等于事件优先级。
这次配置了两条告警规则:
- P2 / Warning:Zone A 的 Kitex 调用超时 QPS 超过
0.05/s。 - P1 / Critical:Zone A 的超时请求比例持续 20 秒超过 25%。
P0 需要进一步结合核心业务是否大范围不可用、影响用户数等判断,不能单凭 RPC 超时比例确定。以上阈值是实验配置,线上应根据业务 SLO 和历史基线制定。
收到两条告警,值班人员应该优先评估 P1:指标影响多大、是否持续、还有没有其他核心链路受损。不能只按邮件到达顺序处理。
2.2 二、响应异常
发现严重告警以后,先确认已经有人接手。很多团队会在告警卡片上点“认领/确认”,或者在值班群说明“已看到,正在排查”,防止多人重复处理或无人处理。
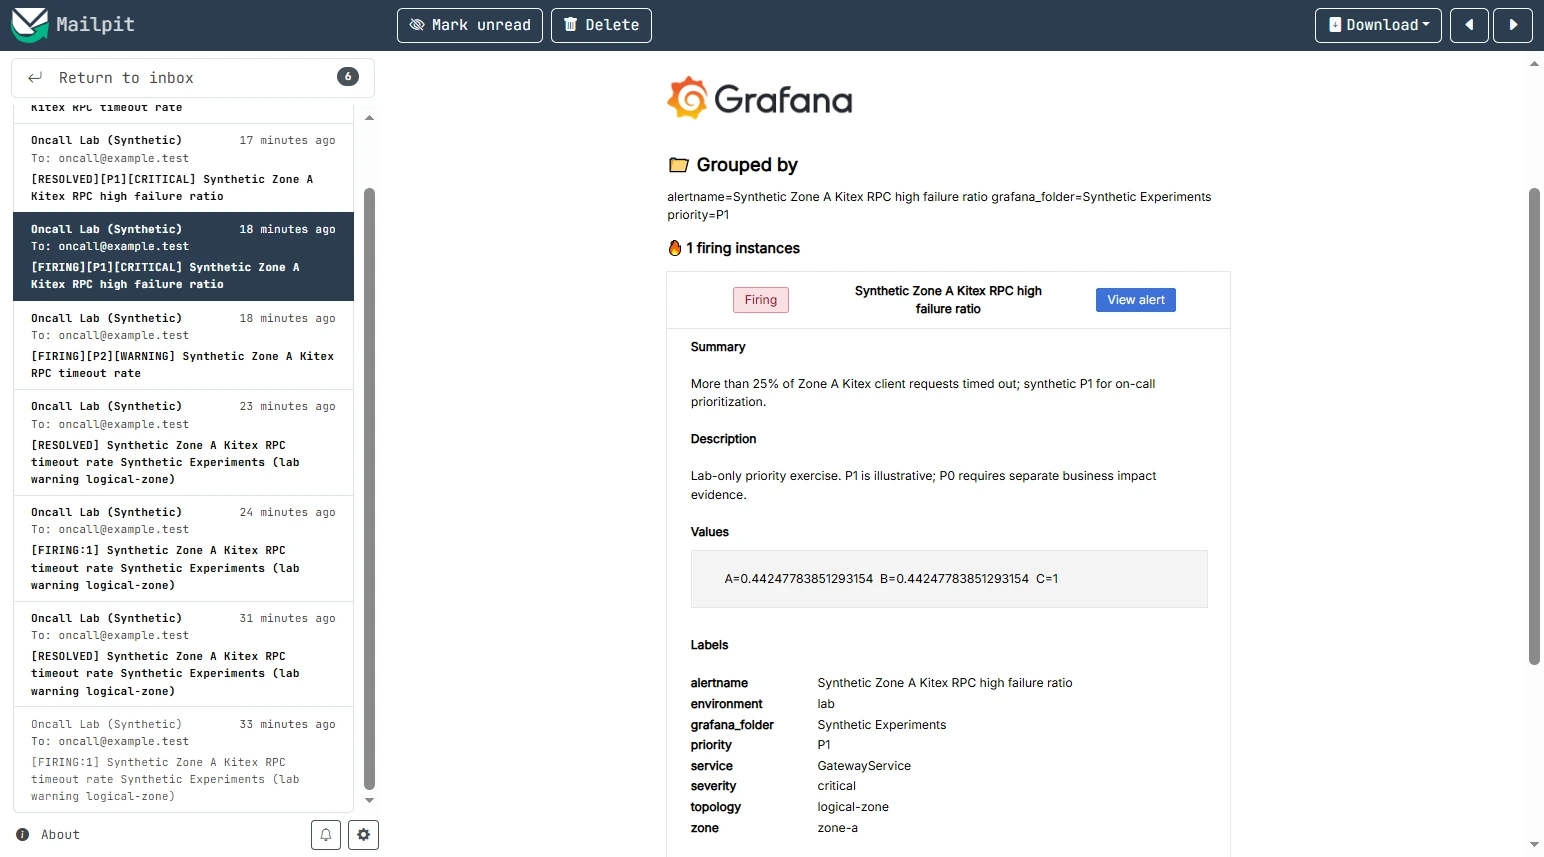
邮件收到后,还需要有人明确认领。已读不等于已处理:如果值班平台支持 ACK,就在平台上确认;否则在协作渠道说明自己已经接手。
接手之后最好立刻记下四个信息:
- 告警触发时间与指标异常时间;
- 服务、方法、环境和事件级别;
- 是否正在持续,是否有恢复通知;
- 当前 Owner、沟通渠道与下一次同步时间。
接下来先弄清异常发生的时间、范围和指标来源,再判断是客户端、服务端还是中间链路的问题。
2.3 三、理解异常上下文
所谓理解异常上下文,最起码回答两个问题:
- 什么时候、哪个地方、发生了什么异常?
- 正常情况下是什么样的?
先看请求记录。Load Generator 共发送 2,675 次请求,分为正常、故障和恢复三个阶段。
| 阶段 | 请求量 | 失败量 | 观察 |
|---|---|---|---|
| 基线(12 秒) | 299 | 0 | 三个 Zone 正常 |
| 故障(60 秒) | 1,500 | 370 | 只有 Zone A 发生超时 |
| 恢复(35 秒) | 876 | 0 | 三个 Zone 恢复正常 |
| 合计 | 2,675 | 370 | 所有请求均有实验日志记录 |
这组数字来自 Load Generator 的真实请求结果,不应与不同时间段的 Prometheus Counter 累计值混用。测试的请求时钟和指标抓取时钟也不完全重合,因此小时间窗内按 rate() 算出的瞬时 QPS,不一定等于上表用请求数量除以整个阶段时长得到的平均 QPS。
故障阶段 Zone A 共有 820 次调用、370 次失败,失败比例约 45.1%。Zone B 408 次、Zone C 272 次,均无失败。对全部 Zone 而言,故障窗口失败率为 370/1500 ≈ 24.7%,不是 45.1%。
这里有两个容易混淆的口径:
Zone A 失败率:只看 A 的请求。全链路失败率:以 A/B/C 的总请求为分母。
P1 的告警规则使用前一种口径:Zone A 的失败比例持续超过 25%。所以它触发,并不代表全链路失败率也超过 25%。
2.3.1 指标到底是什么,由谁上报?
收到“调用超时”告警,首先要弄清指标的定义。至少有几种可能的来源:
| 位置 | 可能的指标 | 含义与边界 |
|---|---|---|
| 调用方 | RPC 客户端请求数、成功数、超时数、耗时 | 反映调用方实际看到的结果 |
| 网关或代理 | 路由/连接错误、转发延迟、状态码 | 反映代理所能观察到的流量 |
| 被调用方框架 | 服务端请求量、方法耗时、服务端错误 | 反映请求是否被服务端接收和处理 |
| 业务代码 | 自定义错误码、业务校验失败 | 取决于埋点所在的代码位置 |
| 基础设施 | CPU、内存、Pod 重启、节点网络指标 | 反映资源或运行状态,不等于 RPC 结果 |
| Redis、MQ、数据库等依赖 | 自身的吞吐、超时、队列和连接指标 | 只能证明各自的观测范围 |
本次排查涉及两组指标:Kitex 框架的 Prometheus 指标,以及 Gateway、Metadata 自己记录的应用指标。
例如:
kitex_client_throughput:来自 Kitex 客户端框架扩展,可按其真实标签和状态分组。rpc_client_requests_total:Gateway 应用层统计的实际 RPC 调用结果,标签包含result、error_code。rpc_server_requests_total:Metadata 服务端 Handler 的实际处理结果。process_cpu_seconds_total、process_resident_memory_bytes:真实进程资源指标。
客户端超时与服务端失败不是一回事。客户端可能已经放弃等待,但服务端 Handler 仍在继续执行。后面可以从两端日志和 Trace 对上时间。
2.3.2 查历史告警,而不是只看眼前的一条
打开 Grafana 的告警历史,可以看到:
Normal --> Alerting --> Normal
                  |
            Mailpit FIRING
            Mailpit RESOLVED
Grafana 将状态变化写入 Loki State History,Mailpit 则收到对应的触发和恢复通知。
历史告警主要看三件事:是否反复出现、每次持续多久、是否与特定变更或流量高峰重合。再对比昨天同一时段或上周同期的 QPS、错误率和延迟,判断异常是新出现的还是一直存在。历史上出现过类似波动,也不能作为忽略当前告警的依据。
2.4 四、分析异常
前面收集到的基本信息是:
- 故障时间:本次合成实验的 60 秒故障窗口。
- 调用链:
GatewayService → MetadataService.GetMetadata。 - 现象:客户端 Kitex RPC 超时,Zone A 出现异常;B/C 目前没有失败。
- 告警:P2 Warning 和 P1 Critical 都曾触发,随后恢复。
接下来逐项排查,先查变更,再看监控数据。
2.4.1 查看变更记录
无论分析什么异常,第一步都应该检查最近是否有变更。
先查调用方,再查被调用方:
- Gateway 最近是否发布了代码、修改了路由或超时配置?
- Metadata 最近是否发布、扩缩容、重启,或者更换了实例?
- 上下游依赖、配置、服务发现是否发生了变化?
- 每项变更的实际时间,是否与告警窗口重合?
变更记录至少包含:时间、操作对象、操作类型、变更前后版本、执行结果。
可以通过 Docker 获取实例启动时间和镜像 ID:
docker inspect oncall-lab-gateway-zone-a1-1 \
  --format '{{.Created}} {{.Image}} {{.State.StartedAt}}'

docker inspect oncall-lab-metadata-zone-a1-1 \
  --format '{{.Created}} {{.Image}} {{.State.StartedAt}}'

python3 scripts/capture_changes.py
重建 gateway-zone-c2 后,比较前后的 StartedAt 和 Image ID:启动时间变了,镜像没有变化。
因此,“实例最近启动过”和“最近发布了新代码”不是同一回事。审查还应继续比较镜像 Digest、代码提交、配置版本及 Deployment Revision。
重启记录也需要结合告警时间判断关联性。单独看到一个新的 StartedAt,还无法确认它和这次超时有关。
如果真实线上正在发布且告警持续扩大,优先考虑止损或回滚,再保留变更记录作分析。发布本身是否一定引起错误,留到附录 4.1 进一步验证。
2.4.2 查看监控整体情况:先上游,再下游
查完变更,再看整体监控。先用较长时间窗口判断系统是否一直处于异常状态,再缩小到告警附近的几分钟。具备历史数据时还要比较前一天同一时段。
这里首先查看 Gateway(调用方):
- 请求 QPS 有没有突增?
- 成功率是不是下降,下降持续了多久?
- P95/P99 延迟是否同步变化?
- 进程 CPU、RSS 内存是否异常?
- 有没有其他方法在相同时间异常?不相关的峰值不能算成本次证据。
然后查看 Metadata(被调用方):
- 服务端是否收到了对应的请求?
- 服务端处理 QPS 是否同步变化?
- Handler 处理耗时怎样?
- 所有实例都受影响,还是只涉及部分实例?
- 资源是否饱和,是否出现重启或不就绪?
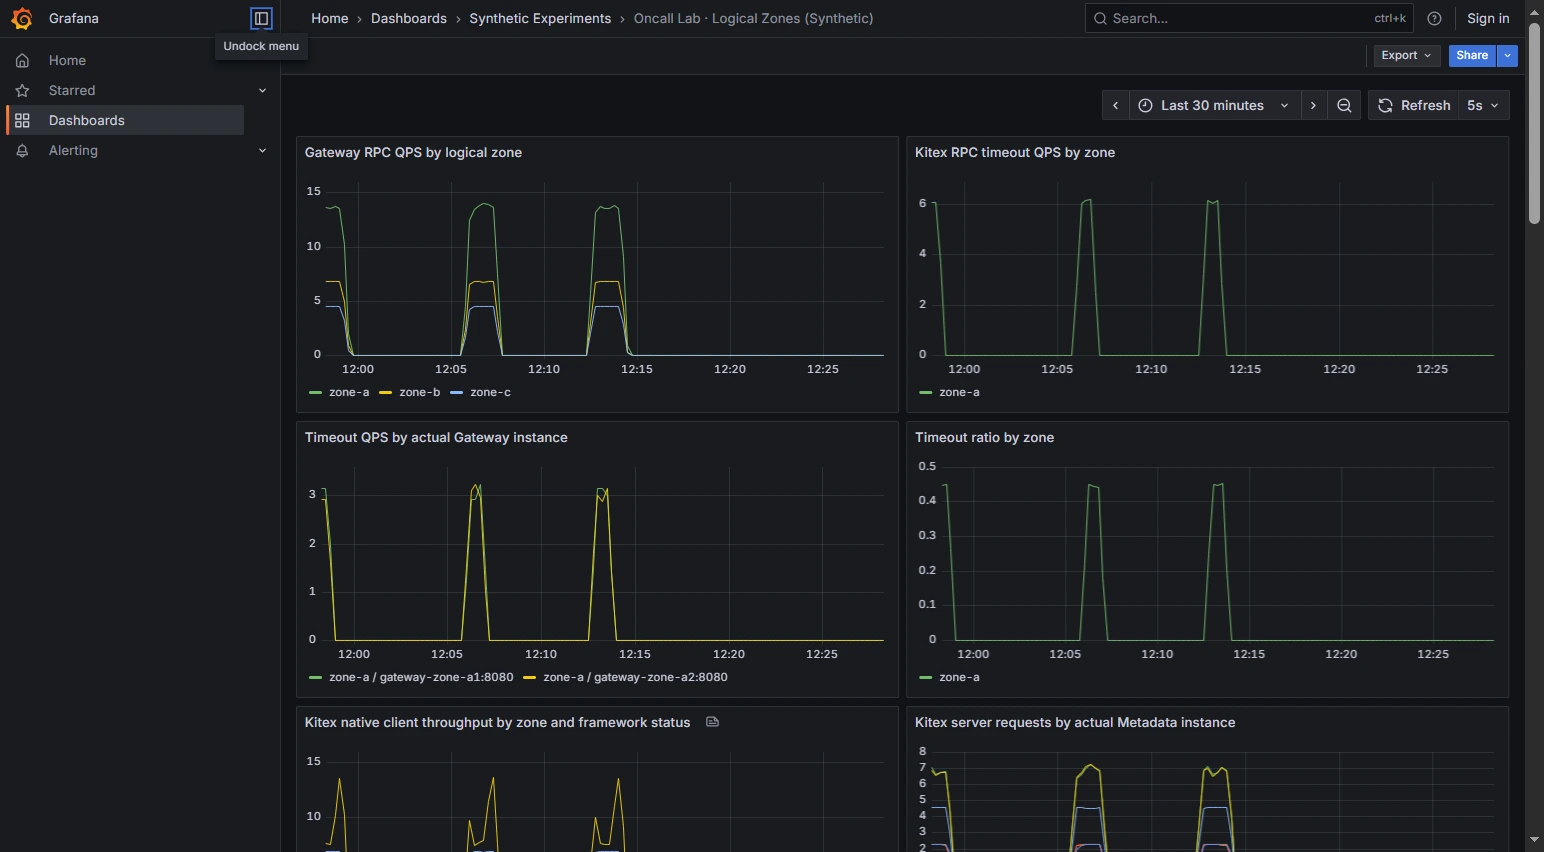
Grafana 同时展示了进程 CPU 和 RSS。即使 CPU 没有明显升高,也要继续检查连接池、锁等待、IO 和局部实例热点。
对比三个阶段的总 QPS,没有出现与错误率同步的流量突增。接下来应检查请求分布,看看异常是否集中在某个 Zone 或某台实例。
2.4.3 详细分析异常指标:时间、环境、Zone、实例与错误码
整体监控确认客户端在超时。接下来要找出哪些请求出错,以及它们有什么共同点。
固定的 Dashboard 用来观察整体趋势;进一步排查时,打开 Grafana Explore,通过 PromQL 按指标标签过滤和分组。
实际操作时,先选择 Prometheus 数据源,确定时间窗口,再选择指标、标签过滤条件和聚合维度。下面的查询可以直接粘贴到 Explore 的 PromQL 模式。
第一步:选择时间范围,对照正常窗口。
先查询客户端失败 QPS:
sum(
  rate(rpc_client_requests_total{
    env="lab",
    result!="success",
    zone=~"zone-.*"
  }[30s])
)
查看基线、故障、恢复三个时间段,并与总 QPS 对比:
sum(rate(rpc_client_requests_total{env="lab",zone=~"zone-.*"}[30s]))有历史数据时,可以使用 Grafana 的 Time shift 或 PromQL offset 1d 对比昨天同一时段。
另外,要区分 rate(counter[30s]) 与直接读 Counter 的差别:Counter 会随着实例重启清零,不同实例的累积值不能随意相加后和旧窗口对账。大部分用于排查的 QPS 曲线应使用 rate(),对某一段内的新增请求量才考虑 increase()。
第二步:按环境过滤。
在 PromQL 中,通过标签选择器过滤,通过 sum by (...) 按标签分组。
例如:
sum by (env) (
  rate(rpc_client_requests_total{result="timeout"}[30s])
)
这里的 env 只有 lab。线上排查则应同时对照生产、预发等环境,确认是否为某个环境特有的问题。
第三步:按机房或 Zone 分组。
sum by (zone) (
  rate(rpc_client_requests_total{
    env="lab",
    result="timeout",
    zone=~"zone-.*"
  }[30s])
)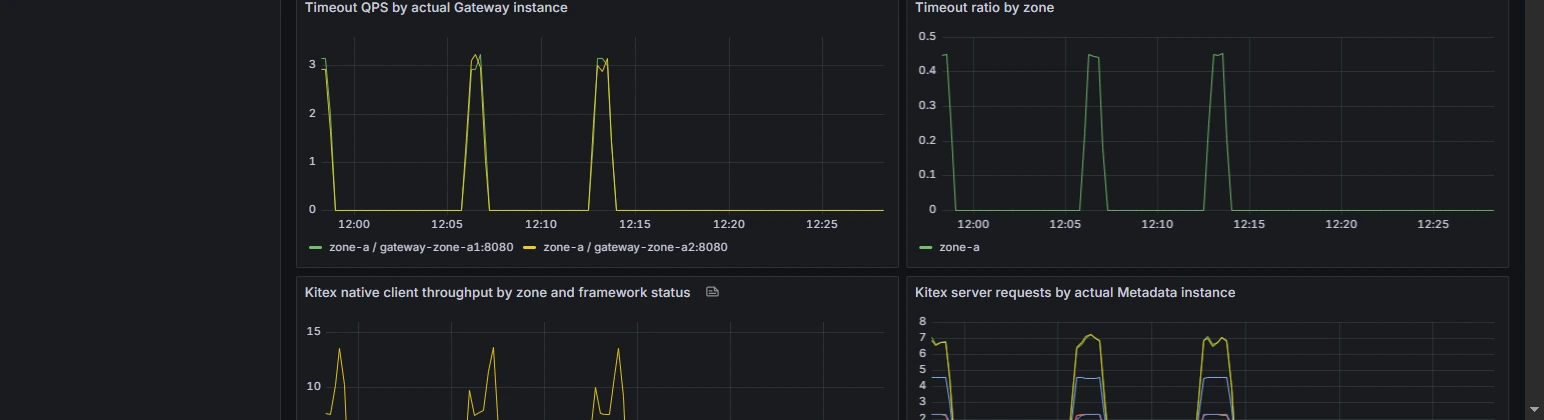
按 Zone 分组后,结果很清楚:错误集中在 Zone A,B/C 没有失败请求。
zone 来自 Prometheus 的抓取标签,对应三个 Docker 逻辑 Zone。
在真实生产环境,如果发生单机房错误,优先检查该机房是否还有其他服务持续告警,节点、网络、DNS、负载均衡和服务发现是否异常。仅凭单个服务在 Zone A 有错误,还不能断言整个 Zone 故障。
第四步:既然是单 Zone,会不会是单实例?
继续按调用方实例分组:
sum by (zone, instance) (
  rate(rpc_client_requests_total{
    zone="zone-a",
    result="timeout"
  }[30s])
)
或者在故障窗口内查看增量:
sum by (instance) (
  increase(rpc_client_requests_total{
    zone="zone-a",
    result="timeout"
  }[1m])
)
这里的 instance 是 Prometheus 抓取的 Gateway 客户端实例,不是下游 Metadata 的 IP。不能因为图上有两条 instance 曲线,就直接把它们解释成两个服务端实例。
Zone A 有两条独立的 RPC 调用路径:
gateway-zone-a1  --Kitex/Thrift-->  metadata-zone-a1
gateway-zone-a2  --Kitex/Thrift-->  metadata-zone-a2
故障阶段的原始 Load Generator 统计为:
| Gateway 实例 | 请求数 | 失败数 | 故障窗口失败率 |
|---|---|---|---|
gateway-zone-a1 |
409 | 184 | 约 45.0% |
gateway-zone-a2 |
411 | 186 | 约 45.3% |
| Zone A 合计 | 820 | 370 | 约 45.1% |
两个 Gateway 实例都出现了约 45% 的超时,不是单台 Gateway 故障。接下来要看对应的 Metadata 服务端是否也有类似异常。
服务端接收情况可以进一步查询:
sum by (zone, instance) (
  rate(rpc_server_requests_total{zone="zone-a"}[30s])
)
客户端失败次数与服务端 Handler 的“成功次数”可能不同:RPC 超时可以发生在客户端等不到响应时,而服务端仍可能完成工作。后面要靠同一条 Trace 检验这个机制。
如果错误只集中在一台实例,应先确认这台实例的流量、延迟、资源、运行版本和依赖是否特殊,再选择摘流或迁移;如果需要研究现场,不应该在尚未保留证据时直接删掉实例。附录 4.3 和 4.6 专门讨论这两个问题。
第五步:排查 Zone 级故障,再解释各 Zone QPS 差异。
错误集中在 Zone A,是否只是因为它承担的请求更多?先查总 QPS,不能直接拿失败 QPS 比大小:
sum by (zone) (
  rate(rpc_client_requests_total{zone=~"zone-.*"}[30s])
)再计算各 Zone 失败率:
sum by (zone) (
  rate(rpc_client_requests_total{result!="success",zone=~"zone-.*"}[30s])
)
/
clamp_min(
  sum by (zone) (
    rate(rpc_client_requests_total{zone=~"zone-.*"}[30s])
  ),
  0.000001
)
Load Generator 按以下权重分配请求:
Zone A:Gateway A1 权重 3,A2 权重 3  => 总权重 6
Zone B:Gateway B1 权重 2,B2 权重 1  => 总权重 3
Zone C:Gateway C1 权重 1,C2 权重 1  => 总权重 2

总权重 11
理论流量份额:A 6/11、B 3/11、C 2/11
故障阶段真实请求数分别为 820 / 408 / 272,与该权重分配相符。
这说明Zone A 承载更多总流量是路由配置导致的预期现象,不能拿 A 的绝对失败数较多当作“机房网络坏了”的直接证据。
但它不能解释为什么失败只发生在 Zone A。因为 B、C 同样收到请求,却没有失败;A 的失败比例约 45%,远高于其他两个 Zone 的 0%。
每个 Zone 有两台 Metadata,Gateway 与 Metadata 一对一绑定。因此这里的比例来自入口权重,并非服务发现自动均衡的结果。附录 4.4、4.5 再讨论请求如何分配到具体实例。
第六步:按错误码继续分组。
确定故障范围后,再按错误类型或错误码分组。Gateway 指标提供了 error_code 标签:
sum by (zone, error_code) (
  rate(rpc_client_requests_total{
    zone=~"zone-.*",
    result!="success"
  }[30s])
)
主案例的错误是 rpc_timeout。再对比另外两种错误场景:
| 触发条件 | Gateway 结果 | 错误证据 |
|---|---|---|
| Metadata Handler 人为延迟 1500ms | HTTP 504 | Kitex RPC Timeout,error_code=rpc_timeout |
Metadata 主动返回 Kitex BizStatusError(2101) |
HTTP 502 | 框架传递的业务错误,error_code=biz_2101 |
| 停止一个 Metadata 容器 | 可能 HTTP 504 | Kitex 连接/解析错误日志;重试可能耗尽同一个 RPC 超时预算 |
2101 是 Metadata 返回的测试业务错误码,用于区分业务返回错误和 RPC 超时。
HTTP 504 只能说明调用没有在预算内完成。 DNS、连接建立、重试、服务端处理和等待回包都可能占用时间,不能仅凭状态码判断慢在哪里。
下一步查日志,找出一条失败请求,沿着 Trace 追踪这次 RPC。
2.4.4 查日志:错误码 → 请求标识 → Trace → 超时预算
第一步:确认日志是否真的存在。
Gateway 和 Metadata 将 JSON 日志写入共享日志目录,Promtail 采集后发送到 Loki。同一个 trace_id 可以关联两端日志。
进入 Grafana Explore,选择 Loki,查询失败请求:
{job="oncall-lab", result="timeout", instance="gateway-zone-a1"}也可以按合成业务错误查:
{job="oncall-lab", error_code="biz_2101"}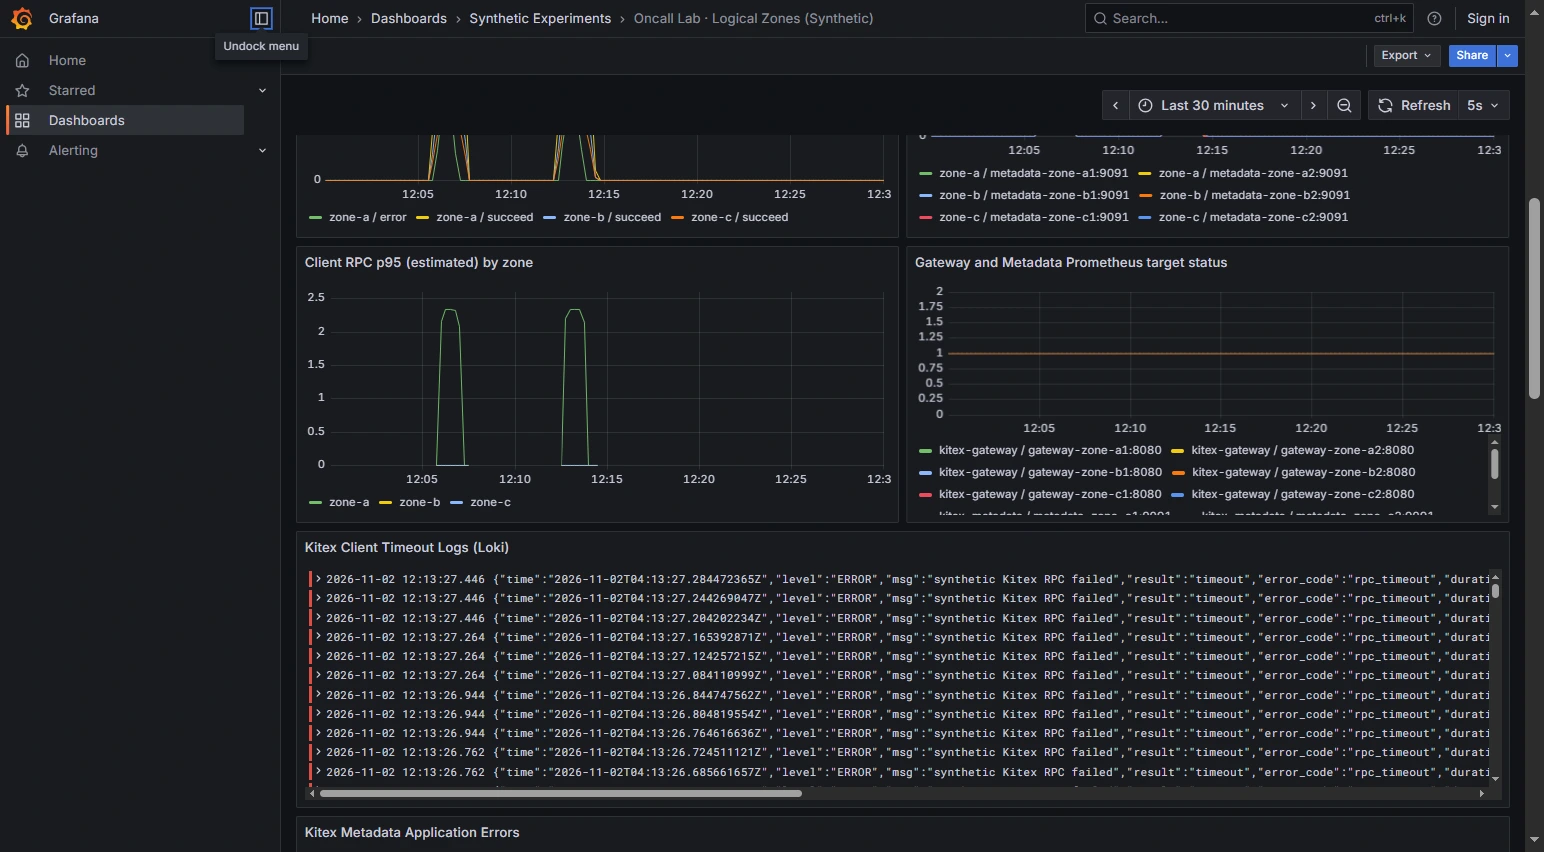
查不到日志时,先检查查询时间范围、采集状态和保留期限,再判断请求是否真正经过该实例。
第二步:取一条具体错误,确认错误来源。
例如这条实验故障,请求进入 Gateway 后调用 Metadata,客户端预算为 1200ms,但 Metadata 收到的指令是延迟 1500ms。
Gateway 日志里有:
{
  "msg": "synthetic Kitex RPC failed",
  "result": "timeout",
  "error_code": "rpc_timeout",
  "trace_id": "<实验中真实生成的 32 位 Trace ID>",
  "zone": "zone-a",
  "instance": "gateway-zone-a1"
}
找到错误日志后,复制其中的 trace_id;上面的 JSON 只展示关键字段。
第三步:根据 Trace ID 关联调用方与服务端。
通过 LogQL 按原始 ID 过滤:
{job="oncall-lab"} |= "实际复制的trace_id"然后进入 Tempo。实际验收的一条超时链路有三个真实 Span:
GatewayService
└── HTTP GET /metadata                   约 1201 ms
    └── Kitex Client GetMetadata         约 1201 ms
        └── MetadataService GetMetadata  约 1501 ms
检查三层 Span 的 trace_id 和父子关系,确认它们属于同一次请求。
从这条 Trace 可以看出:
- 客户端在约 1200ms 结束等待,认为 RPC 超时。
- 服务端 Handler 仍然运行到约 1500ms,记录处理完成。
- 服务端回包时,可能发现客户端连接已结束,产生额外的写回告警。
如果只看客户端,会误以为“下游 RPC 失败”。如果只看 Metadata 的 Handler Counter,又可能发现“服务端执行成功”。两者并不矛盾,它们观察的是不同的生命周期边界。
第四步:核对连接超时和 RPC 超时是否相同。
当前真实 Go 代码明确配置:
client.WithRPCTimeout(1200 * time.Millisecond),
client.WithConnectTimeout(200 * time.Millisecond),
两者必须分开理解:
ConnectTimeout=200ms:单次建立连接阶段的超时设置。RPCTimeout=1200ms:一次 Kitex RPC 的总超时预算。
发生重试时,连接错误也可能耗尽 RPC 的总预算。需要结合 Kitex 错误日志,分清建连失败、请求超时和业务返回错误。
在后端容器停止实验中,我们实际看到了 DNS/连接获取错误,最终客户端仍可能因为重试耗尽 1200ms 的 RPC 预算而返回 HTTP 504。这个反例说明:同一个上层状态码,可以对应不同的下层失败机制。
第五步:耗时到底花在哪里?
如果框架具有细粒度事件记录,可以进一步分析:
请求发起
  -> 获取或建立连接
  -> 编码并写出请求
  -> 等待返回数据
  -> 读取并解码
  -> 业务处理完成
当前 Trace 记录到 RPC 客户端和服务端 Span 粒度;若要进一步拆解网络读写,需要更细的框架事件或抓包信息。
客户端 Span 很长,可能是服务端处理慢、网络慢、排队、连接或其他等待。不能因为一次 Client Read 等待很久,就直接断定“网络传输慢”。在这次实验里,我们能够结合真实 Metadata Handler 的 1500ms 延时指令和服务端 Span,确认主要原因是服务端受控处理延迟;如果没有这些证据,就需要继续查更细的事件或在必要时抓包。
如果怀疑网络重传或建连异常,可以继续通过 tcpdump、Wireshark 检查 TCP 重传、RTT 和握手时间。
2.4.5 分析代码:从日志回到正在运行的版本
根据前面的指标和 Trace,可以确认:
- 异常出现在 Zone A 的两个客户端实例。
- 调用方实际收到 Kitex Timeout。
- 服务端 Handler 的处理时长超过了客户端预算。
- Metadata 服务端可以比 Gateway 更晚结束。
接下来不是翻开本地最新代码就算分析完成,而是要确认:正在运行的实例究竟来自哪次构建?
需要从以下几项对齐:
实际运行容器 / Pod
    ↓ Image ID / Digest
镜像版本与构建提交
    ↓
对应代码仓库、分支、Commit
    ↓
日志打印位置 / Tracer 记录位置
    ↓
本次 RPC 生效的超时配置与 Handler 逻辑
首先核对容器的 Image ID、启动时间和实际配置,再根据镜像构建记录找到对应的 Git Commit。只看本地最新代码,容易漏掉线上仍在运行的旧版本。
相关代码位置:
| 环节 | 仓库内位置 | 观察点 |
|---|---|---|
| RPC 客户端 | cmd/gateway/main.go |
连接超时、RPC 超时、错误分类和日志 |
| RPC 服务端 | cmd/metadata/main.go |
合成 1500ms 延迟、业务错误、Handler 结果 |
| 压测器 | cmd/loadgen/zone.go |
按 Zone 选择请求并只对 A 注入延迟 |
| Trace | Gateway / Metadata 的 OTel Suite | 父子 Span 及跨服务传播 |
| 指标 | Kitex Prometheus Tracer + 应用 Counter | 客户端与服务端统计边界 |
例如故障注入的逻辑本质上是:
select {
case <-time.After(time.Duration(delayMs) * time.Millisecond):
    // 真实的服务端延迟
case <-ctx.Done():
    // 在请求上下文取消后尽早返回
}
此外,Gateway 将 kerrors.IsTimeoutError(err) 或 context.DeadlineExceeded 识别为 rpc_timeout,将 Kitex BizStatusError 提取为 biz_2101。这可以回到源码逐行验证。
代码与配置需要能解释日志里的行为。若对不上,先检查镜像版本、配置生效范围和部署记录。
2.5 五、给出结论
排查到这里,可以把现象、失败机制和原因分开整理。
第一层:已经确认的现象
- 本轮实验共有 2675 次请求,故障窗口 1500 次,其中 370 次失败。
- 失败集中在 Zone A,B/C 没有失败;Zone A 两个 Gateway 分别记录 184、186 次失败。
- P2 Warning、P1 Critical 均实际触发并发送邮件,恢复后两级告警都回到正常状态。
- 客户端表现为 Kitex RPC Timeout / HTTP 504。
第二层:已验证的直接失败机制
Gateway 的 Kitex RPC 超时预算是 1200ms,Zone A 的部分请求使 Metadata Handler 延迟 1500ms。客户端先达到等待上限,因此返回超时;服务端 Handler 仍可能运行完成。两端日志和跨服务 Trace 与这一机制相符。
第三层:触发条件
故障注入脚本只在故障阶段对 Zone A 的部分请求设置 delay_ms=1500。
因此这次超时的直接原因很明确:服务端处理时间超过了客户端 RPC 超时预算。在线上排查时,即使看到相同的超时现象,还需要继续查清为什么服务端变慢:是资源耗尽、锁等待,还是下游依赖超时。
还有一个重要区分:短暂恢复不等于问题已经解决。如果错误周期性重现,即使每次只有几十秒,仍可能需要查明根因。也不建议仅仅因为“不影响太大”就直接永久屏蔽告警。
2.6 六、推进问题的解决
如果错误正在影响业务,止损和分析可以并行。
- 确认是刚发布版本引起的高影响故障:优先评估暂停发布或回滚,并观察指标回落。
- 错误集中在单个实例且仍有可替代容量:可以先摘流,但尽量保留进程、日志和现场。
- 确认资源瓶颈且扩容能改善:检查现有容量、负载策略和扩容速度,必要时扩容。
- 属于下游依赖异常:联系对应服务 Owner,同步错误比例、时间窗口、Trace ID 和当前止损措施。
- 如果根因不确定:明确写出尚未排除的假设,不要把“一次缓解”描述成“根因彻底修复”。
关闭延迟注入后,恢复阶段 876 次请求全部成功,Mailpit 也收到 P1、P2 的 RESOLVED 邮件。
2026-11-02 本地演示
P2/Warning  --> FIRING  --> RESOLVED
P1/Critical --> FIRING  --> RESOLVED

注意:通知实际送达存在分组等待和去重延迟。
告警指标恢复与恢复邮件送达不是同一时刻。
恢复验证不能只看邮件是否写了 RESOLVED;还要看调用成功率、超时 QPS、实例健康情况、实际用户请求是否恢复,以及有无复发趋势。
恢复后还要向相关负责人同步:采取了什么措施、根据哪些指标确认恢复、后续由谁负责观察。
2.7 七、总结并沉淀文档
一个有价值的 On-call 复盘,重点不只是“最后发现是超时”。
更应该保存:
- 异常最初是什么样:原始告警、指标名、业务含义、触发时间。
- 优先级怎么定:为什么先处理它,哪些影响还需要进一步核实。
- 查过哪些变更:变更记录与故障时间能否对应。
- 先排除了什么:例如 QPS 未突增、B/C 正常、并非单 Gateway 实例。
- 怎么逐步下钻:时间 → 环境 → Zone → 实例 → 错误码 → 日志 → Trace → 代码。
- 哪些结论有证据,哪些只是猜测:尤其是客户端错误与服务端真实行为的差异。
- 采取了什么止损措施,如何证明恢复:包括邮件、指标、健康状态和真实请求结果。
这样做的好处在于,下次换成 Redis 超时、数据库连接池耗尽或 MQ 消费积压时,仍然可以复用大部分思路,而不必重新记一套平台点击操作。
3. 实战再实战
RPC 超时只是其中一种场景。换成 Redis、MQ 或数据库,排查思路类似,但指标入口和失败机制不同。
| 场景 | 优先查看的指标 | 继续下钻的方向 |
|---|---|---|
| 客户端 | 错误率、DNS/连接耗时、请求超时、重试次数 | 网络、版本、请求大小、客户端限流与重试 |
| 网关 / 负载均衡 | 入口 QPS、状态码、上游和后端错误、路由分布 | 网关规则、健康检查、转发与连接复用 |
| 业务服务 | RPC 成功率、P95/P99、CPU/RSS、实例数 | 代码、锁、连接池、线程/Goroutine、依赖调用 |
| Redis | 命令延迟、连接数、CPU、内存、热点 Key | 慢命令、热点、容量、连接池和网络 |
| MQ | 生产/消费速率、积压量、消费延迟 | 分区、消费者数量、重试与死信 |
| 数据库 | 活跃连接、慢 SQL、锁等待、CPU、IO | SQL 执行计划、索引、事务和连接池 |
例如 Redis 超时,看到服务 CPU 很低,并不能证明 Redis 没问题;MQ 消费积压也不能简单用“多加消费者”解决,可能受到分区数或下游数据库吞吐限制。
遇到不同组件,先明确告警指标的含义,再结合上下游依赖和具体错误类型逐步缩小范围。
4. 附录:六个值得继续追问的问题
排查过程中还会遇到六个常见问题:服务发布会不会报错?扩容什么时候生效?如何摘流同时保留现场?跨 Zone QPS 为什么不同?实例是否均衡?实例故障后会不会自动迁移?
这些问题都可以用公开系统做实验。为了区分机制,下面使用独立的 Kind Kubernetes 集群:
一台电脑
  ├── Kind Control Plane(1 个)
  ├── Kind Worker A:topology.kubernetes.io/zone=lab-zone-a
  ├── Kind Worker B:topology.kubernetes.io/zone=lab-zone-b
  └── Kind Worker C:topology.kubernetes.io/zone=lab-zone-c

Metadata Deployment:期望副本数 6
Gateway Deployment:期望副本数 1
Service / EndpointSlice:管理就绪的服务端点
Metrics Server:供 HPA 读取资源指标
Kind 的三个 Worker 运行在同一台机器上,主要用来观察 Kubernetes 的调度、发布、服务端点和副本管理。
下面各实验共用一个 Kind 环境;先按 README 的 Kind 准备章节 初始化一次:
bash k8s/up.sh之后可以只运行你想验证的附录,不需要每次重建整个集群。
4.1 发布服务时会导致服务报错吗?
复现命令:python3 k8s/rollout-traffic.py。在持续 Kitex RPC 请求期间触发 Kubernetes Rolling Restart,结果记录在 evidence/;详细前置条件见 README。
有可能,但不是滚动发布必然报错。
把问题拆成四个方面会更容易理解。
4.1.1 滚动粒度与间隔
如果一次下线太多实例,剩余实例可能承受过高流量;如果更新速度太快,新 Pod 尚未真正可用,旧 Pod 已退出,也可能造成容量缺口。
在 Kubernetes Deployment 中,相关配置是:
strategy:
  type: RollingUpdate
  rollingUpdate:
    maxSurge: 1
    maxUnavailable: 1
Deployment 期望维持 6 个服务端副本;滚动过程中最多增加 1 个副本、允许 1 个副本不可用。这些参数控制发布容量,服务发现缓存的收敛时间还需要单独观察。
下面分别验证了两种情况:
- 滚动重启 6 个 Metadata Pod,检查替换后是否全部恢复 Ready。
- 持续发送 420 次真实 Kitex RPC,约 10 QPS,每次处理约 900ms,在请求仍然进行时触发 Rolling Restart。
持续请求下完成滚动更新后,420 次 RPC 全部返回 HTTP 200。如果请求耗时超过退出宽限期,或者服务发现收敛更慢,结果可能不同。
4.1.2 摘流、Endpoint 与服务发现收敛
发布过程中典型时序是:
Pod 开始终止 / Readiness 变化
         ↓
EndpointSlice 更新就绪端点
         ↓
调用方、代理或 Service 路由逐步看到变化
         ↓
已有连接与在途请求处理
         ↓
进程退出或被强制结束
这里涉及多个异步组件。即使 EndpointSlice 已经删除旧端点,既有 TCP 连接也未必立即消失。若客户端继续复用一个正在退出的连接,就可能出现短暂错误。
Kubernetes Service 不等于你应用框架内部的服务发现缓存。具体需要测的是:路由层何时停止新请求、框架何时停止接收、旧请求是否完成、连接何时关闭。
4.1.3 框架优雅退出与强制终止
Kubernetes 有 terminationGracePeriodSeconds,还可以配置 preStop。但这些配置本身不保证应用一定优雅退出。
正确的顺序需要应用框架配合:
- 停止接收新的请求或把 Readiness 置为不就绪。
- 给上游一段发现和摘流时间。
- 等待或有界处理在途请求。
- 在终止宽限期内关闭连接和进程。
如果 preStop 时间、框架 Drain 时间与终止宽限期没有协调好,超过时间后进程仍可能被强制停止,导致在途调用失败。
当前配置的 preStop sleep 3 只提供退出前的短暂等待,真正的连接排空还需要 Kitex 服务端配合关闭监听、处理在途请求,并验证调用方连接复用的行为。
4.1.4 发布的新代码是否有问题
即使基础设施的滚动过程完全正常,新版本仍可能引入错误:序列化不兼容、配置错误、业务逻辑 Bug、下游负载变化等。
因此需要用小流量发布期间的错误率和延迟判断是否继续放量;与变更时间高度重合时,要把回滚作为止损候选,而不是先花大量时间猜原因。
结论:发布可能引起错误,其来源可能是容量、发现/连接收敛、退出时序或代码本身。只有看清这四条链,才能决定该调整哪一处。
4.2 自动扩容为什么可能赶不上异常?
复现命令:bash k8s/metrics-server.sh,然后 bash k8s/hpa.sh。观察 HPA 的目标副本数,而不是把手动 kubectl scale 当成自动扩容。
发现 QPS 上涨、CPU 使用率升高时,一个自然想法是扩容。但要问清:谁检测到扩容条件、多久触发一次、何时新增实例真正可接流量?
Kubernetes HPA 的简化链路:
CPU 使用率升高
    ↓
Metrics Server 采集 Pod 的 CPU 指标
    ↓
HPA Controller 根据目标利用率计算目标副本数
    ↓
Deployment / ReplicaSet 新建 Pod
    ↓
调度到节点 → 镜像可用 → 容器启动 → Readiness 通过
    ↓
EndpointSlice 增加新的就绪服务端点
    ↓
新请求才有机会被导向新实例这里每一步都可能有延迟。尤其需要区分期望副本数已经上升和实际 Ready 容量已经增加。
我们在 Kind 上运行真实的 Metrics Server,并设置:
minReplicas: 6
maxReplicas: 9
metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 65
随后向 Metadata Pod 注入有界的 CPU 工作负载。实验期间,HPA 观察到 CPU 使用率约为目标值的数倍,实际把期望副本数从 6 提升到了 9。结束后清理 CPU 负载和 HPA,恢复到 6 个 Pod。
副本数由 HPA 根据 CPU 利用率自动调整,和手动执行 kubectl scale 不同。
如果某个突发高峰持续只有几秒,HPA 控制环、Pod 启动和服务发现收敛可能来不及完成扩容。还有可能 CPU 不高,但连接池或下游依赖先成为瓶颈。此时扩容不一定能解决问题,甚至可能向下游施加更大压力。
4.3 实例出问题后,如何摘流同时保留现场?
复现命令:bash k8s/drain.sh。验证 Pod 保持 Running,而 EndpointSlice 就绪端点由 6 减到 5、再恢复到 6。
遇到单实例故障,最简单的操作是直接重启或删除 Pod。但这样可能丢失正在排查的进程状态:连接池、堆栈、内存对象、临时文件和现场日志。
如果还有足够的健康容量,通常更希望先让该实例不再接收新流量,再保留实例分析。
我们用 Kubernetes Readiness 实际验证:
正常:6 个 Metadata Pod Running + Ready
      EndpointSlice:6 个 ready endpoints

对其中一个 Pod 写入实验标记:
      /tmp/oncall-not-ready

观察:
      Pod Phase 仍然 Running
      /healthz 返回 200(Liveness 正常)
      /readyz 返回 503(Readiness 不通过)
      EndpointSlice:ready endpoints 从 6 降到 5

移除标记:
      Pod 不用重建
      /readyz 恢复 200
      EndpointSlice:ready endpoints 从 5 回到 6
可以用脚本真实重放:
k8s/drain.sh这说明“不再参与接收新流量”与“进程是否还活着”应该是两个独立概念。
但需要强调两点:
- Readiness 移除 Endpoint 后,旧连接可能仍在使用,需要结合代理、Kitex 连接池和在途请求观察实际摘流效果。
- 保留现场不是无限制保留。若实例存在持续影响业务的故障,必须在安全和业务影响之间取舍。
Readiness 通过 EndpointSlice 控制新流量入口;若使用服务发现权重摘流,还要分别验证权重更新和客户端连接缓存的收敛时间。
4.4 如何判断不同机房的请求负载是否均衡?
复现入口:沿用第 0 节的 Docker 主实验,在 compose.zones.yaml 查看 ZONE_ROUTES 权重,再到 Grafana 的 Zone QPS 面板对照真实流量;完整查询与验收见 README。
我们在正文看到了 Zone A 的请求 QPS 高于 B/C。为什么?
回答这个问题之前,需要弄清楚用户的一次请求究竟经过哪些路由层。一个典型的互联网系统可能包含:
用户终端
   ↓ DNS / CDN / 接入入口
公网网关或边缘代理
   ↓ 区域 / Zone 级流量选择
负载均衡或 API Gateway
   ↓ 服务发现 / 代理 / 应用 RPC 客户端
具体服务实例
不同接入架构的路由层次可能不同。先找到实际决定流量去向的那一层,再分析权重和健康状态。
第一,先区分地域、可用区和实例。
- Region 通常表示较大的地理区域或部署区域。
- Zone / Availability Zone 通常表示更细的故障域。
- Data Center 是实际物理设施,和云服务商的逻辑 AZ 不必一一对应。
- Pod / Container / Instance 是运行工作负载的单位,不是机房。
Kind 实验里的 lab-zone-a/b/c 是我们贴在三个 Worker Node 上的 Kubernetes 标签,不是真实 Region 或 AZ 的网络故障域。
第二,先看总流量,再看错误率。
如果三个 Zone 的总流量本来就是 55%、27%、18%,那么 Zone A 的绝对错误数比其他 Zone 多,有可能只因为它承担了更多请求。
但要进一步问:同类请求在各 Zone 的条件失败率是否也不同?正文实验中只有 A 的超时比例达约 45%,B/C 为 0%,说明“请求更多”本身不能解释故障集中。
第三,检查路由权重与健康状态。
Load Generator 的权重由 compose.zones.yaml 中的 ZONE_ROUTES 控制。线上排查还需要检查:
- DNS/CDN 是否按地区或健康状态选择入口?
- 区域级负载均衡是否配置了固定权重?
- 是否有故障切流、就近访问、灰度发布或黑白名单?
- 各区域实际有多少健康实例?规格与容量是否一致?
- 是否存在连接复用、会话保持、Hash 路由?
- 是否有不同区域的流量成本或延迟目标?
这里不能简单使用“实例数越多,机房 QPS 必然越高”的推论。只有在路由权重按实例数量分配、实例权重一致且请求满足相应的分配假设时,它才可能近似成立。
正文中,三 Zone 虽然都有两台真实 Metadata,但负载生成器的入口权重就是 6:3:2。这才是实验流量比例的直接原因。
更进一步的问题是:如果入口平均,为什么某些实例仍然会接到绝大多数请求?下一节继续分析。
4.5 实例请求负载一定均衡吗?
复现命令:python3 k8s/load-balancing.py。通过真实 Pod 的 RPC Counter 对比一次请求实验的实例分布,不能预设 Kubernetes Service 会均分每个 RPC。
排查实例负载不均衡,建议依次检查三个维度。
第一,机器规格是否相同。
不同实例的 CPU、内存、连接容量和运行代码可能不一致。一个实例即使 QPS 较低,也可能因为请求复杂、依赖慢而先达到瓶颈。因此比较实例负载不能只看 QPS,还要结合延迟、CPU、连接、请求分布与实际处理成本。
第二,实例权重是否相同。
一些负载均衡系统支持实例权重。例如 1:2 的权重,在统计窗口足够长、流量足够均匀的情况下,可能使两个实例承载约 1:2 的新流量。需要查看运行时生效的权重,而不只是配置文件默认值。
第三,负载均衡到底按什么单位分配?
继续看实际请求分布。
Kind 中有六个 Metadata Pod。通过同一个 Gateway 向 Kubernetes Service 发送 240 次 Kitex RPC,再比较各 Pod 的 rpc_server_requests_total 增量。
实测结果是:
通过同一个 Kubernetes Service:
240 次 Kitex RPC

Metadata Pod 1:240 次
Metadata Pod 2:  0 次
Metadata Pod 3:  0 次
Metadata Pod 4:  0 次
Metadata Pod 5:  0 次
Metadata Pod 6:  0 次
这个结果并不意味着 Kubernetes 永远只会把请求发送给第一台 Pod。它说明在这次实验的单客户端、持久连接复用条件下,ClusterIP 对连接的分配与 RPC 请求粒度并不相同。
简单理解:
按连接建立时选后端
Gateway ──一条被复用的 TCP 连接──> Metadata Pod 1
             |
             +-- RPC 1
             +-- RPC 2
             +-- ...
             +-- RPC 240
对这个场景,六个 Pod 实例数量相同、规格相同,也不意味着“每个 Pod 都会分到 40 次 RPC”。
如果需要更均匀的按请求分配,可以研究客户端框架的发现/负载均衡策略、连接池模型、代理层的每请求路由、权重与已有连接的行为,但必须用真实连接及实例 Counter 验证。只改变 replicas 数量,无法保证一定改善此类热点。
所以还要问一句:负载均衡发生在连接建立时、每个 RPC 请求时,还是更上游的一层?
4.6 异常实例能否自动迁移?
复现命令:bash k8s/lifecycle.sh。观察 Pod 删除后 ReplicaSet 自动补齐、滚动替换与最终 Ready 状态;这里验证的是 Kubernetes 自愈,不是跨物理机房迁移。
如果实例发生异常,理想的恢复路径可能是:摘流、退出、由控制器创建新实例、重新加入发现系统。但“自动迁移”涉及几个不同概念,不能混在一起:
- 进程重启:同一个 Pod 内重新启动容器,Pod 身份可能不变。
- Pod 替换:删除或终止旧 Pod,ReplicaSet 创建新的 Pod,UID 和 IP 可能变化。
- 跨节点重新调度:新 Pod 被调度到另一个 Node。
- 跨故障域迁移:实例真正离开故障区域,前提是系统具有独立的故障域和相应策略。
可以直接删除一个 Pod,观察 ReplicaSet 的反应:
kubectl -n oncall-lab delete pod <某个真实的-metadata-pod>

kubectl -n oncall-lab rollout status deployment/metadata

kubectl -n oncall-lab get pods -o wide
ReplicaSet 随后补齐六个副本,Deployment 恢复 6/6 Ready。这里观察到的是 Pod 自愈替换;是否跨节点或故障域,还要对比新旧 Pod 的 nodeName。
我们还配置了:
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone
    whenUnsatisfiable: DoNotSchedule
    labelSelector:
      matchLabels:
        app: metadata
这里有一个实测反例:滚动更新结束后,实际看到过三个逻辑 Zone 的 Pod 数为 3/2/1,并没有始终保持 2/2/2。之后通过重新创建过量 Zone 的 Pod,才恢复均衡。
Topology Spread Constraints 约束新 Pod 调度时的放置,不会自动迁移已经运行的 Pod。若需要持续再均衡,还要设计 Descheduler、节点维护和容量策略。
所以讨论实例自动迁移时,我更关心三件事:
- 检测机制:是什么让系统确认实例需要替换?Liveness、Node NotReady、业务健康检查还是自定义指标?
- 迁移代价:有没有中断在途请求?是否丢失本地状态?新实例什么时候真正 Ready?
- 故障域:新实例是不是仍在同一个坏节点、同一 AZ?有没有新的容量和网络约束?
同样的动作,在“把 Pod 从坏容器里重建”和“把服务真正迁出一个故障机房”之间,可能存在数量级不同的工程复杂度。
5. 总结
回看这次 RPC 超时排查,最初只有两封告警邮件和一个失败指标。
先确认告警等级和影响范围,再查历史与变更、整体监控、Zone 和实例分布。根据 rpc_timeout 进入 Loki,沿 Trace 对照客户端和服务端耗时,最后回到超时配置和 Handler 代码。
最后能得到一组明确的排查结果:
- 哪里出错:Zone A,而不是全部 Zone。
- 是否单实例:不是,两个真实 Gateway 都失败。
- 是不是流量更多造成的错觉:A 的确承担更多流量,但其条件失败率异常,B/C 正常。
- 错误类型是什么:客户端 Kitex RPC Timeout。
- 服务端发生了什么:服务端 Handler 可能继续执行完 1500ms。
- 为什么客户端先失败:1200ms 的 RPC 等待预算耗尽。
- 如何证明恢复:正常请求恢复、超时指标下降、Grafana 告警回归 Normal、Mailpit 收到恢复邮件。
附录又从发布、扩容、摘流、跨 Zone 路由、实例负载均衡和 Pod 替换六个方向追问了系统机制。
同一条排查路径也可以用于其他 RPC 或依赖故障:先缩小影响范围,再沿着调用链定位具体的失败阶段。
软件工程没有银弹。这套方法不一定覆盖所有故障,但至少能让排查有明确顺序:先确定影响范围,再逐层验证假设,直到找到能够解释现象的证据。
实验代码与参考资料
实验仓库:oncall-lab。启动与验收见第 0 节,详细配置和附录命令见 中文 README 和 English README。
实验采用的公开组件可以参考:CloudWeGo Kitex、Kitex Prometheus 扩展、Grafana Explore、Kubernetes Deployment、Pod Topology Spread Constraints 和 HPA。
拖动可平移,滚轮缩放,点击节点可展开或折叠。大型导图默认折叠较深层级,可点击节点继续展开。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看