
NOTE
LLM
从模型规模与自监督学习出发,梳理大语言模型的训练流程、架构演进、推理和优化方法。
LLM
LLM是什么
- 规模较大的LM
- 规模
- 训练数据
- 参数量
- 计算量
- 为什么只有LM才能大
- 其他算法
- 目标检测
- 代表模型:YOLO
- 主题建模
- 代表模型:LDA
- 目标检测
- 自监督
- 不需要标注数据
- 对比监督学习 需要人工标注数据
- 其他算法
- 规模
如何构建LLM
-
- 准备训练数据
- LLM 预训练数据来源
- ├── 1. 网络公开数据(Web Data)
- │ ├── Common Crawl
- │ ├── 自建网页爬虫
- │ └── 经过清洗的网页语料
- ├── 2. 专业数据
- │ ├── 学术论文
- │ ├── 图书
- │ └── 代码仓库
- ├── 3. 授权数据(Licensed Data)
- │ └── 通过授权协议获取的数据
- 盗版
- 已经证实的案例:Anthropic / 2025 年,美国加州联邦法院审理了 Bartz v. Anthropic 案件。 / 法院文件披露,Anthropic 曾获取: / 数据来源 / 规模 / 情况 / Books3 / 约 19.7 万本 / 2021 年下载 / Library Genesis(LibGen) / 至少 500 万本 / 2021 年下载 / Pirate Library Mirror(PiLiMi) / 至少 200 万本 / 2022 年下载
- 盗版
- │ └── 通过授权协议获取的数据
- └── 4. 合成数据(Synthetic Data)
- └── 由模型或程序生成的数据
- 既然有AI生成的数据,为什么数据还会缺少数据
- 数量
- AI 可以不断生成文本,理论上近乎无限
- 质量
- AI 生成的内容不一定正确,也不一定具有足够的信息价值。
- 模型坍塌:不加区分地使用前代模型生成的数据进行递归训练,可能使模型逐渐丢失原始数据分布中的长尾信息。
- AI 生成的内容不一定正确,也不一定具有足够的信息价值。
- 多样性
- 即使生成的内容都正确,也可能因为缺乏新知识和多样性而无法继续提升模型能力。
- 即创新?
- 就如同人:归纳让你发现规律,溯因让你提出解释,演绎让你推导可检验的预测,实验让你验证假设。 / 这三种推理相互配合,才构成比较完整的科学研究过程。 / 斯坦福哲学百科全书 / 还有一个关键区别:提出一个别人没有提出过的假设,只是潜在的创新;经过验证、确实产生新价值或新知识,才能进一步确认为创新成果。
- https://chatgpt.com/c/example
- 即创新?
- 即使生成的内容都正确,也可能因为缺乏新知识和多样性而无法继续提升模型能力。
- 数量
- ├── 1. 网络公开数据(Web Data)
-
- 模型设计
- 模型架构
- Transformer
- 基于seq2seq
- 是什么
- 是一种将输入序列转换成输出序列的建模方式。
- 模块
- 编码器
- 将输入序列编码成内部表示
- 有点类似于压缩
- 输入token,输出表示输入的最终隐藏状态
- 过程
- 第一步:Tokenizer,将文本转换为 Token ID
- 第二步:Embedding,将 Token ID 转换为向量
- 第三步:RNN Encoder 依次计算隐藏状态
- 图例
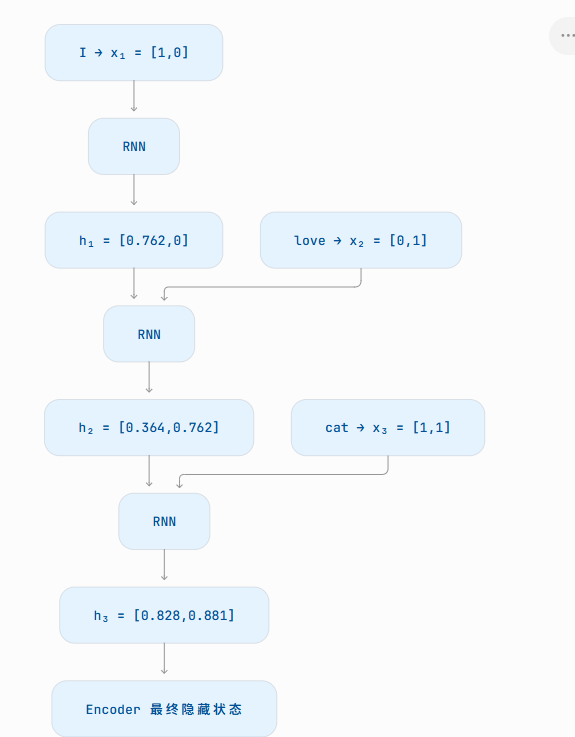
- 输入文本 / “I love cat” / ↓ / Tokenizer / [1, 2, 3] / ↓ / Embedding / x₁ = [1,0] / x₂ = [0,1] / x₃ = [1,1] / ↓ / RNN Encoder / h₁ = RNN(x₁,h₀) / h₂ = RNN(x₂,h₁) / h₃ = RNN(x₃,h₂) / ↓ / 输出上下文相关的隐藏状态 / h₃ = [0.828,0.881] / ↓ / 传递给 Decoder
- 输入文本 / “I love cat” / ↓ / Tokenizer / [1, 2, 3] / ↓ / Embedding / x₁ = [1,0] / x₂ = [0,1] / x₃ = [1,1] / ↓ / RNN Encoder / h₁ = RNN(x₁,h₀) / h₂ = RNN(x₂,h₁) / h₃ = RNN(x₃,h₂) / ↓ / 输出上下文相关的隐藏状态 / h₃ = [0.828,0.881] / ↓ / 传递给 Decoder
- 将输入序列编码成内部表示
- 解码器
- 根据内部表示,逐步生成输出序列。
- 过程
- (未命名主题)
- 和编码器一样,只不过多了把隐藏状态转换为概率的步骤
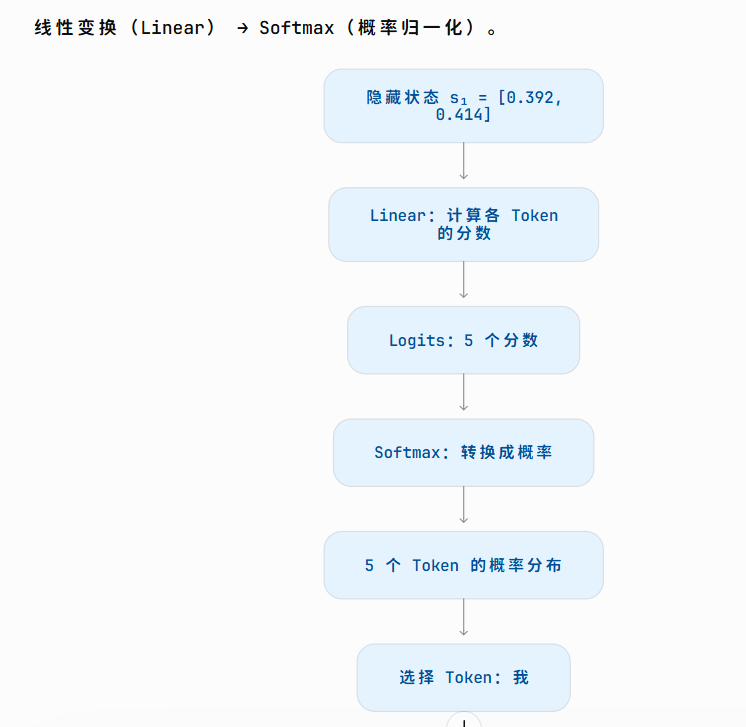
- 之所以叫隐藏,其实是中间状态的意思: / state := []float64{0, 0} / for _, token := range tokens { / state = RNN(token, state) / }
- Linear
- Linear:把隐藏状态转换成每个候选单词的分数
- logit分数
- https://chatgpt.com/c/example
- Linear:把隐藏状态转换成每个候选单词的分数
- Softmax
- 把logit分数转换成概率
- 和编码器一样,只不过多了把隐藏状态转换为概率的步骤
- (未命名主题)
- 图例
- 编码器和解码器都是使用RNN
- 循环神经网络的
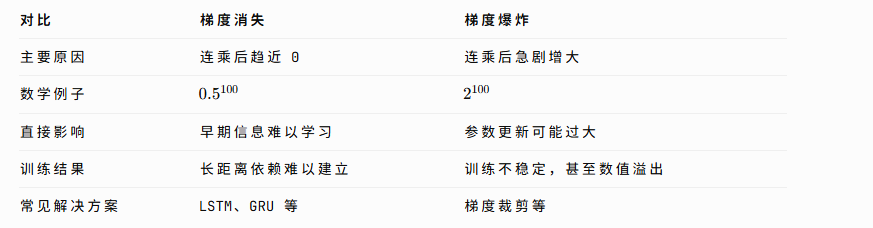
- 梯度
- 梯度就是损失函数对某个变量的导数,用来衡量变量变化会如何影响损失。
- 问题
- 梯度消失
- 梯度爆炸
- 梯度就是损失函数对某个变量的导数,用来衡量变量变化会如何影响损失。
- 梯度
- 这里的循环指的是神经网络在处理序列时,把上一步的状态传递给下一步。
- 循环神经网络的
- 编码器
- 问题
- 解决
- 注意力机制
- 它继承了经典 Seq2Seq 的编码器—解码器思路,但用 Attention(注意力机制)替代了传统 RNN 的循环计算。
- 注意力机制
- 串行计算(Sequential Computation)
- RNN Encoder 必须依赖上一个 Token 的隐藏状态,导致序列内部难以并行计算。
- 信息瓶颈(Information Bottleneck)
- 经典 Seq2Seq 将整个输入序列压缩成一个固定长度的向量,Decoder 很难从中恢复全部重要信息。
- 类比无损压缩
- 一个固定容量的向量,不可能无损表示所有任意长度的输入序列。
- 传统 RNN Seq2Seq 采用固定长度向量,根本上是一种信息容量与计算成本之间的工程权衡。
- 传统 RNN Seq2Seq / │ / ├── 固定长度状态 / ├── 计算和存储开销较小 / └── 长序列存在信息瓶颈 / ↓ / RNN + Attention / │ / ├── 保留多个位置的隐藏状态 / ├── Decoder 按需读取信息 / └── 增加计算和存储成本 / ↓ / Transformer / │ / ├── Attention 成为核心计算机制 / ├── 不再依赖 RNN 的串行状态传递 / ├── 提高训练并行能力 / └── 面临长序列计算成本问题
- 类比无损压缩
- 经典 Seq2Seq 将整个输入序列压缩成一个固定长度的向量,Decoder 很难从中恢复全部重要信息。
- 解决
- 过程
- 训练过程:模型如何学会翻译
- Encoder + Decoder + Loss + 反向传播
- 输入序列(英文) 输出序列(中文) / I love cats. → 我 爱 猫 。
- 训练数据:x=2,y=10 / │ / ▼ / ① 前向传播 / ŷ = ax²+b / a=1,b=1 / ŷ=5 / │ / ▼ / ② 计算 Loss / L=(5-10)²=25 / │ / ▼ / ③ 反向传播 / ∂L/∂a=-40 / ∂L/∂b=-10 / │ / ▼ / ④ 优化器更新参数 / a = 1.4 / b = 1.1 / │ / ▼ / ⑤ 再次前向传播 / ŷ=1.4×4+1.1=6.7 / │ / ▼ / ⑥ 计算新的 Loss / L=(6.7-10)²=10.89 / │ / ▼ / 重复训练
- https://chatgpt.com/c/example
- 对于 (y=ax^2+b) 这个函数,如果我们把它当成一个最简单的机器学习模型,那么需要训练的参数就是 (a) 和 (b)。 / 我们用具体数字,完整走一遍: / 前向传播 → 计算 Loss → 反向传播求导 → 更新参数 → 再次预测。 / 一、先定义模型和训练数据 / 假设我们有一个模型: / [ / \boxed{\hat y=ax^2+b} / ] / 这里用 (\hat y) 表示模型的预测值。 / 变量 / 含义 / 初始值 / (x) / 输入数据 / 2 / (y) / 真实答案(Target) / 10 / (a) / 可学习参数 / 1 / (b) / 可学习参数 / 1 / (\hat y) / 模型预测值 / 待计算 / 我们的目标是: / 通过训练,让模型在输入 (x=2) 时,尽可能预测出 (y=10)。 / 注意:这里的 (a)、(b) 就相当于神经网络中的可学习参数(权重和偏置)。不过,(ax^2+b) 本身只是一个简单的参数化数学模型,不是典型的多层神经网络。 / 二、第一步:前向传播(Forward) / 将数据代入: / [ / \hat y=ax^2+b / ] / [ / \hat y=1\times2^2+1=5 / ] / 得到: / - 真实答案:10 / - 模型预测:5 / 显然,模型预测错了。 / 那么,究竟错了多少? / 这就需要 Loss。 / 三、第二步:计算 Loss / Loss(损失函数)就是一个衡量预测结果与正确答案之间差距的数学函数。 / 我们这里使用平方误差: / [ / \boxed{L=(\hat y-y)^2} / ] / 为什么这里不使用交叉熵? / 因为: / - 平方误差通常用于回归任务,例如预测连续数值。 / - 交叉熵通常用于分类任务,例如预测下一个 Token 的概率分布。 / 两者都是 Loss,只是适用于不同的任务。 / 代入: / [ / L=(5-10)^2=25 / ] / 因此: / 当前 Loss = 25。 / 到这里,整个过程都只是普通的数学计算。 / 没有求导,也没有更新参数。 / 四、第三步:反向传播(Backpropagation) / 现在是最关键的部分。 / 我们知道 Loss = 25,但是: / 到底应该修改 (a),还是修改 (b)?修改多少? / 首先把整个计算关系写出来: / [ / L=(ax^2+b-y)^2 / ] / 我们希望找到更合适的 (a)、(b),使 Loss 减少。 / 1. 对参数 a 求导 / 根据链式法则: / [ / \frac{\partial L}{\partial a} / = / \frac{\partial L}{\partial\hat y} / \cdot / \frac{\partial\hat y}{\partial a} / ] / 分别计算: / [ / \frac{\partial L}{\partial\hat y} / =2(\hat y-y) / ] / [ / \frac{\partial\hat y}{\partial a}=x^2 / ] / 因此: / [ / \frac{\partial L}{\partial a} / =2(\hat y-y)x^2 / ] / 代入当前数据: / [ / =2(5-10)\times 2^2 / ] / [ / \boxed{\frac{\partial L}{\partial a}=-40} / ] / 2. 对参数 b 求导 / 同样使用链式法则: / [ / \frac{\partial L}{\partial b} / = / \frac{\partial L}{\partial\hat y} / \cdot / \frac{\partial\hat y}{\partial b} / ] / 因为: / [ / \frac{\partial\hat y}{\partial b}=1 / ] / 所以: / [ / \frac{\partial L}{\partial b} / =2(\hat y-y) / ] / 代入: / [ / \boxed{\frac{\partial L}{\partial b}=-10} / ] / 现在我们有了两个梯度: / 参数 / 当前值 / 梯度 / (a) / 1 / -40 / (b) / 1 / -10 / 反向传播到这里就完成了。 / 它并没有修改参数,而是告诉我们: / - 增大 (a),可以让当前 Loss 下降。 / - 增大 (b),也可以让当前 Loss 下降。 / - 当前 Loss 对 (a) 的局部变化更敏感。 / 这就是求导的意义。 / 五、第四步:优化器更新参数 / 假设我们使用最简单的梯度下降算法(Gradient Descent)。 / 设置学习率: / [ / \eta=0.01 / ] / 更新公式: / [ / \theta_{\text{new}} / = / \theta_{\text{old}}-\eta\frac{\partial L}{\partial\theta} / ] / 更新 a / [ / a_{\text{new}}=1-0.01\times(-40) / ] / [ / \boxed{a_{\text{new}}=1.4} / ] / 更新 b / [ / b_{\text{new}}=1-0.01\times(-10) / ] / [ / \boxed{b_{\text{new}}=1.1} / ] / 现在模型从: / [ / \hat y=x^2+1 / ] / 变成: / [ / \boxed{\hat y=1.4x^2+1.1} / ] / 注意,我们并没有修改模型的数学结构,只是修改了其中的参数。 / 六、第五步:再次前向传播 / 还是使用同一条训练数据: / [ / x=2,\quad y=10 / ] / 新的预测: / [ / \hat y=1.4\times2^2+1.1 / ] / [ / \boxed{\hat y=6.7} / ] / 计算新的 Loss: / [ / L=(6.7-10)^2=10.89 / ] / 对比训练前后: / 更新前 / 更新后 / 参数 (a) / 1 / 1.4 / 参数 (b) / 1 / 1.1 / 预测值 / 5 / 6.7 / Loss / 25 / 10.89 / 经过一次参数更新,Loss 从 25 降到了 10.89。 / 这说明这一次更新有效。 / 但不是所有学习率、所有参数更新都一定能使 Loss 下降。例如学习率过大,可能反而导致 Loss 增加。
- # Seq2Seq 训练流程 / ## 一、是什么 / - Seq2Seq(Sequence-to-Sequence):将输入序列映射为输出序列的建模方式。 / - 经典架构:RNN Encoder–Decoder。 / - 训练本质:通过调整神经网络的参数,使模型预测正确答案的概率尽可能高。 / - 核心流程:前向传播 → Loss → 反向传播 → 参数更新 → 重复训练。 / ## 二、完整训练流程 / ### 1. 准备训练数据 / - Source(源文本):
I love cat/ - Target(目标文本):我 爱 猫 <EOS>/ - 英文原文和中文正确答案都由训练数据提供。 / ### 2. Encoder:编码源文本 / 第一步:Tokenizer / - 将英文文本转换为 Token ID。 / - 示例:I love cat→[1, 2, 3]/ 第二步:Embedding / - 将 Token ID 转换为向量。 / -1 → x₁/ -2 → x₂/ -3 → x₃/ - Embedding 本身也包含可学习的参数。 / 第三步:RNN Encoder / - 输入I: / -h₁ = RNN(x₁, h₀)/ - 输入love: / -h₂ = RNN(x₂, h₁)/ - 输入cat: / -h₃ = RNN(x₃, h₂)/ 第四步:输出最终隐藏状态 / -h₃包含对I love cat的内部表示。 / - 可以理解为对源文本的有损压缩。 / - 将h₃传递给 Decoder,用于初始化其隐藏状态。 / ### 3. Decoder:预测目标文本 / 第一步:初始化 / - 接收 Encoder 最终隐藏状态。 / - 输入特殊 Token:<BOS>。 / 第二步:逐步预测 Token / 每一步执行: / - 输入上一个目标 Token 的 Embedding。 / - RNN 结合上一步隐藏状态计算新的隐藏状态。 / - Linear 将隐藏状态转换为词表分数。 / - Softmax 将分数转换为概率分布。 / - 得到词表中每个 Token 的预测概率。 / 假设: / - 第一步: / - 输入:<BOS>/ - 正确答案:我/ -P(我 | X, BOS) = 0.6/ - 第二步: / - 输入:我/ - 正确答案:爱/ -P(爱 | X, 我) = 0.7/ - 第三步: / - 输入:爱/ - 正确答案:猫/ -P(猫 | X, 我爱) = 0.8/ - 第四步: / - 输入:猫/ - 正确答案:<EOS>/ -P(EOS | X, 我爱猫) = 0.9/ 其中X = I love cat。 / 第三步:Teacher Forcing(教师强制) / - 训练时,每一步都使用真实的上一个目标 Token。 / - 无论模型预测正确还是错误,下一步都使用训练数据提供的 Token。 / - 不需要先选择概率最大的预测结果。 / - 不存在必须超过 50% 概率才能选中的规则。 / ### 4. Loss:计算预测误差 / 是什么 / - Loss 是衡量模型预测结果与真实答案之间差距的数学函数。 / - Token 预测通常使用交叉熵损失(Cross-Entropy Loss)。 / 计算过程 / 每一步的 Loss: /Lₜ = -ln(P(正确 Token))/ 假设正确 Token 的概率分别为: / -P(我) = 0.6/ -P(爱) = 0.7/ -P(猫) = 0.8/ -P(EOS) = 0.9/ 总 Loss: /L = -ln(0.6) - ln(0.7) - ln(0.8) - ln(0.9)/ 结果: /L ≈ 1.196/ 如果使用平均损失: /L_avg ≈ 0.299/ 注意 / - 每一步实际输出整个词表的概率分布。 / - 每一步计算的是下一个 Token 的条件概率,而不是直接计算整个句子片段的概率。 / - Loss 只衡量预测误差。 / - 计算 Loss 不等于求导。 / - 即使预测正确,只要正确 Token 的概率小于 1,Loss 仍然大于 0。 / ### 5. Backpropagation:反向传播 / 是什么 / - 沿前向计算图反方向计算 Loss 对模型参数的梯度。 / - 反向传播的核心数学原理是链式法则。 / 为什么需要 / - 我们已经知道 Loss 的大小。 / - 但不知道应该调整哪些参数,以及调整方向。 / - 因此需要计算 Loss 对各参数的偏导数。 / 执行过程 / - 从总 Loss 开始。 / - 计算 Loss 对 Decoder 参数的梯度。 / - 梯度沿 Decoder 各时间步反向传递。 / - 梯度通过 Encoder–Decoder 的连接继续传回 Encoder。 / - 计算 Encoder 各时间步相关参数的梯度。 / - 获得所有可学习参数的梯度。 / RNN 中,这个过程称为 BPTT(Backpropagation Through Time)。 / 注意 / - 反向传播只计算梯度,不直接修改参数。 / - 不是重新执行一次反方向翻译。 / - 不是计算出参数的最终正确值。 / ### 6. Optimizer:更新参数 / 是什么 / - 优化器根据梯度调整模型参数。 / - 最简单的方法是梯度下降(Gradient Descent)。 / 参数更新公式 /新参数 = 旧参数 − 学习率 × 梯度/ - 梯度:决定参数应调整的局部方向和变化率。 / - 学习率:控制参数调整的步长。 / - 优化器:执行参数更新。 / 更新完成后,使用新的参数继续训练下一批样本。 / — / ## 三、用 y = ax² + b 理解数学原理 / ### 1. 定义模型 / 模型函数: /ŷ = ax² + b/ 变量: / -x:输入数据。 / -y:真实答案。 / -ŷ:模型预测值。 / -a:可学习参数。 / -b:可学习参数。 / 初始条件: / -x = 2/ -y = 10/ -a = 1/ -b = 1/ - 学习率η = 0.01/ 这里的数学函数只是参数优化的简化示例,不是真正的 Seq2Seq 神经网络。 / ### 2. 前向传播:计算预测值 / 模型: /ŷ = ax² + b/ 代入: /ŷ = 1 × 2² + 1 = 5/ 得到: / - 真实答案:10 / - 预测结果:5 / ### 3. Loss:计算误差 / 这里使用平方误差,而不是交叉熵。 / 损失函数: /L = (ŷ − y)²/ 代入: /L = (5 − 10)² = 25/ 将模型代入 Loss: /L = (ax² + b − y)²/ 由于x = 2、y = 10: /L(a,b) = (4a + b − 10)²/ 目的:通过调整 a、b,使 L 尽可能小。 / ### 4. 反向传播:计算梯度 / 为什么对 a、b 分别求偏导 / - Loss 同时受到 a 和 b 的影响。 / - 需要分别计算每个参数变化时,Loss 如何变化。 / - 对其中一个参数求偏导时,将另一个参数视为常数。 / 对 a 求偏导 / 原公式: /L = (4a + b − 10)²/ 根据链式法则: /∂L/∂a = 2(4a + b − 10) × 4/ 代入a = 1, b = 1: /∂L/∂a = 2(4 + 1 − 10) × 4/ 结果: /∂L/∂a = -40/ 对 b 求偏导 /∂L/∂b = 2(4a + b − 10) × 1/ 代入: /∂L/∂b = 2(4 + 1 − 10)/ 结果: /∂L/∂b = -10/ 得到梯度 / - a 的梯度:-40 / - b 的梯度:-10 / 如何理解 / - 两个梯度都是负数。 / - 说明在当前位置,稍微增大 a 或 b,都可以使 Loss 下降。 / - 梯度的绝对值表示当前点附近的局部变化率。 / - -40 和 -10 是梯度,不是参数的新值。 / ### 5. 梯度下降:更新参数 / 为什么还需要学习率 / - 梯度告诉我们局部变化方向和变化率。 / - 但不能直接告诉我们一次应该移动多远。 / - 学习率负责控制步长。 / - 学习率太大可能越过低损失区域,导致 Loss 上升。 / 参数更新公式: /新参数 = 旧参数 − 学习率 × 梯度/ 假设: /η = 0.01/ 更新 a /a_new = 1 − 0.01 × (-40)/ 结果: /a_new = 1.4/ 更新 b /b_new = 1 − 0.01 × (-10)/ 结果: /b_new = 1.1/ 模型从: /ŷ = x² + 1/ 变成: /ŷ = 1.4x² + 1.1/ ### 6. 再次前向传播 / 继续使用相同训练样本: / -x = 2/ -y = 10/ 新的预测: /ŷ = 1.4 × 2² + 1.1 = 6.7/ 新的 Loss: /L = (6.7 − 10)² = 10.89/ 对比 / - 更新前:Loss = 25 / - 更新后:Loss = 10.89 / - 本次更新使 Loss 下降了。 / 继续用当前参数处理下一轮数据,重复训练。 / 注意:只有一条训练数据,不能唯一确定 a、b,也不能保证对其他输入预测正确。 / — / ## 四、数学模型与 Seq2Seq 的对应关系 / ### 输入数据 / - 数学模型:x = 2/ - Seq2Seq:I love cat/ ### 正确答案 / - 数学模型:y = 10/ - Seq2Seq:我 爱 猫 <EOS>/ ### 模型预测 / - 数学模型:ŷ = ax² + b/ - Seq2Seq:Encoder–Decoder 输出每个位置的 Token 概率分布。 / ### 可学习参数 / - 数学模型:a、b/ - Seq2Seq:Embedding、Encoder、Decoder、输出层等的权重和偏置,统称θ。 / ### Loss / - 数学模型:平方误差。 / - Seq2Seq:交叉熵损失。 / ### 反向传播 / - 数学模型:计算∂L/∂a、∂L/∂b。 / - Seq2Seq:计算 Loss 对所有可学习参数的梯度。 / ### 优化器 / - 数学模型:更新 a、b。 / - Seq2Seq:更新整个神经网络的可学习参数。 / — / ## 五、训练与推理的区别 / ### 训练(Training) / - 已知 Source 和 Target。 / - 使用 Encoder 编码源文本。 / - Decoder 使用 Teacher Forcing。 / - 计算各位置的 Token 概率分布。 / - 使用目标 Token 计算 Loss。 / - 通过反向传播计算梯度。 / - 优化器更新模型参数。 / ### 推理(Inference) / - 只有 Source,没有正确 Target。 / - 使用 Encoder 编码源文本。 / - Decoder 从 BOS 开始生成。 / - 使用自己生成的 Token 作为下一步输入。 / - 直到 EOS 或达到其他停止条件。 / - 通常不计算训练 Loss,也不更新参数。 / — / ## 六、最终总结 / 神经网络训练的核心不是直接求出正确参数,而是不断寻找能降低 Loss 的参数。 / 完整过程: / 1. 准备输入数据与正确答案。 / 2. 前向传播,计算模型预测。 / 3. 利用损失函数计算预测误差。 / 4. 反向传播,计算 Loss 对模型参数的梯度。 / 5. 优化器根据梯度与学习率更新参数。 / 6. 使用更新后的参数继续训练。 / 7. 结合验证集效果与训练预算等条件决定何时停止。 / 核心公式 / - 模型预测:ŷ = f(x; θ)/ - 损失函数:L = Loss(ŷ, y)/ - 反向传播:g = ∂L/∂θ/ - 梯度下降:θ_new = θ_old − η × g/ 一句话记忆:前向传播计算预测,Loss 衡量误差,反向传播计算梯度,优化器更新参数。
- https://chatgpt.com/c/example
- 训练数据:x=2,y=10 / │ / ▼ / ① 前向传播 / ŷ = ax²+b / a=1,b=1 / ŷ=5 / │ / ▼ / ② 计算 Loss / L=(5-10)²=25 / │ / ▼ / ③ 反向传播 / ∂L/∂a=-40 / ∂L/∂b=-10 / │ / ▼ / ④ 优化器更新参数 / a = 1.4 / b = 1.1 / │ / ▼ / ⑤ 再次前向传播 / ŷ=1.4×4+1.1=6.7 / │ / ▼ / ⑥ 计算新的 Loss / L=(6.7-10)²=10.89 / │ / ▼ / 重复训练
- 输入序列(英文) 输出序列(中文) / I love cats. → 我 爱 猫 。
- Encoder + Decoder + Loss + 反向传播
- 推理过程:模型如何翻译
- Encoder + Decoder 逐步生成
- encoder和训练完全一致
- 输入:“I love cat” / │ / ▼ / Tokenizer / │ / ▼ / [1, 2, 3] / │ / ▼ / Embedding / │ / ▼ / x₁ x₂ x₃ / │ / ▼ / RNN Encoder / h₁ = RNN(x₁, h₀) / h₂ = RNN(x₂, h₁) / h₃ = RNN(x₃, h₂) / │ / ▼ / 最终隐藏状态 h₃
- decoder
- 没有loss
- 没有反向传播
- 没有教师强制
- 推理(Inference) / │ / ▼ / 输入:I love cat / │ / ▼ / Tokenizer / │ / ▼ / Embedding / │ / ▼ / RNN Encoder / │ / ▼ / 最终隐藏状态 h₃ / │ / ▼ / 初始化 Decoder / │ / ▼ / 输入
/ │ / ▼ / RNN Decoder / │ / ▼ / Linear + Softmax / │ / ▼ / 下一个 Token 概率分布 / │ / ▼ / 选择一个 Token / │ / ▼ / 是否为 ? / │ │ / 否 是 / │ │ / ▼ ▼ / 将生成的 Token 结束 / 输入下一时间步 │ / │ ▼ / │ 输出:我爱猫 / │ / └──→ RNN Decoder
- encoder和训练完全一致
- Encoder + Decoder 逐步生成
- 其实可以对比hashmap
- 训练过程:模型如何学会翻译
- 是什么
- 原始 Transformer
- 模块
- encoder
- self-attension:多了位置信息,可以并行计算
- 传统
- 输入:I love cat / ↓ / Tokenizer / ↓ / Embedding / ↓ / x₁ x₂ x₃ / I love cat / ↓ / RNN Encoder / h₁ = RNN(x₁, h₀) / ↓ / h₂ = RNN(x₂, h₁) / ↓ / h₃ = RNN(x₃, h₂) / ↓ / 最终隐藏状态 h₃ / ↓ / Decoder
- 现在
- 输入:I love cat / ↓ / Tokenizer / ↓ / Embedding / ↓ / 加入位置信息 / ↓ / x₁ x₂ x₃ / I love cat / \ | / / \ | / / ↓ ↓ ↓ / Self-Attention / ↓ / 前馈网络 FFN / ↓ / z₁ z₂ z₃ / ↓ / Decoder
- 传统
- 注意力权重
- 为什么需要
- 因为不同 Token 对当前 Token 的信息贡献可能不同,我们需要一种机制,动态决定应该从哪些 Token 获取多少信息。
- 演进
- 没有权重的情况
- 引入权重
- QKY
- 演进
- 因为不同 Token 对当前 Token 的信息贡献可能不同,我们需要一种机制,动态决定应该从哪些 Token 获取多少信息。
- 为什么需要
- self-attension:多了位置信息,可以并行计算
- decoder
- Masked Self-Attention。
- 传统
- Encoder 最终隐藏状态 h₃ / ↓ / 初始化 Decoder / ↓ / 输入
→ RNN → Linear → Softmax / ↓ / 预测「我」 / ↓ / 输入真实的「我」 / ↓ / RNN / ↓ / 预测「爱」 / ↓ / 输入真实的「爱」 / ↓ / RNN / ↓ / 预测「猫」
- Encoder 最终隐藏状态 h₃ / ↓ / 初始化 Decoder / ↓ / 输入
- 现在
- 目标文本:我 爱 猫
/ Decoder 输入: / 我 爱 猫 / │ │ │ │ / ▼ ▼ ▼ ▼ / Embedding / ↓ / 加入位置信息 / ↓ / Masked Self-Attention / ↓ / Cross-Attention ◄── Encoder 输出 / ↓ / FFN / ↓ / Linear + Softmax / ↓ / 我 爱 猫
- 目标文本:我 爱 猫
- 传统
- Masked Self-Attention。
- encoder
- 过程
- 训练
- Encoder + Decoder + Loss + 反向传播
- 推理
- Encoder 编码 + Decoder 自回归生成
- 训练
- 模块
- GPT 类 Transformer
- 过程
- 推理
- 预填充
- 并行处理输入token
- 输入: / “Translate I love cat into Chinese:” / │ / ▼ / Tokenizer / │ / ▼ / Embedding / │ / ▼ / Transformer Decoder / 并行处理输入 Token / │ / ├── 建立 KV Cache / │ / ▼ / 预测第一个 Token / │ / ▼ / 我
- 并行处理输入token
- 解码
- 顺序输出token
- 已经生成:我 / │ / ▼ / Transformer Decoder / 利用 KV Cache / │ / ▼ / 预测:爱 / │ / ▼ / Transformer Decoder / 利用 KV Cache / │ / ▼ / 预测:猫 / │ / ▼ / Transformer Decoder / │ / ▼ / 预测:EOS / │ / ▼ / 我爱猫
- 顺序输出token
- 预填充
- 训练
- 使用因果掩码并行预测多个 Token,计算 Loss 并更新参数
- 推理
- 模块
- 只有decoder
- 过程
- 讲解
- 基于seq2seq
- Transformer
-
- 训练
- 过程
- 预训练
- │ ├── 自监督学习
- │ ├── 前向传播(Forward)
- │ ├── 损失函数(Loss)
- │ ├── 反向传播(Backward)
- │ ├── 优化器(Optimizer)
- │ └── 输出:预训练基础模型
- 目的
- 预训练让模型学会语言、知识和一定的推理能力
- 后训练
- 目的
- 让模型学会如何按照人类的要求使用这些能力。
- 过程
- 监督微调
- 依赖人工标注
- 叫模型怎么回答
- 假设用户问: / Go 的 GMP 调度模型是什么? / 人工提供一个高质量答案: / GMP 是 Go 的运行时调度模型,由 G(Goroutine)、M(Machine)和 P(Processor)组成…… / 模型通过学习大量这样的问答数据,调整参数,使自己更擅长遵循指令。 / 本质:给模型示范正确的回答方式,让它模仿学习。
- 偏好微调
- 教模型回答的更好
- 同样的问题,模型产生两个回答: / 回答 A: / GMP 是 Go 的调度模型。 / 回答 B: / GMP 由 G、M、P 三个核心组件组成,分别承担任务、执行线程和调度资源的职责…… / 标注人员认为 B 更好。 / 模型根据偏好数据调整参数,提高生成优质回答的概率。 / 本质:通过比较不同回答,让模型学会更符合人类偏好的行为。
- 技术
- RLHF:基于人类反馈的强化学习。
- 常需要先训练一个奖励模型,再通过强化学习优化 LLM
- LLM 生成回答 / ↓ / 奖励模型进行评分 / ↓ / PPO 等强化学习算法 / ↓ / 更新 LLM 参数 / ↓ / 让模型更倾向于生成高奖励回答
- DPO:直接偏好优化。
- 直接利用人类偏好数据优化 LLM,省去了独立奖励模型和强化学习过程。
- 问题 / ├── 回答 A:较差 / └── 回答 B:较好 / ↓ / DPO Loss / ↓ / 更新 LLM 参数
- RLHF:基于人类反馈的强化学习。
- 教模型回答的更好
- 监督微调
- 目的
- 预训练
- 规模
- 三大要素
- 过程
- (未命名主题)
- 模型(Model) / 用什么模型学习? / 参数量、架构、参数效率
- 数据(Data) / 用什么数据训练? / 数量、质量、多样性
- 算力(Compute) / 用多少计算资源训练? / GPU 数量、性能、显存、训练时长、FLOPs
- (未命名主题)
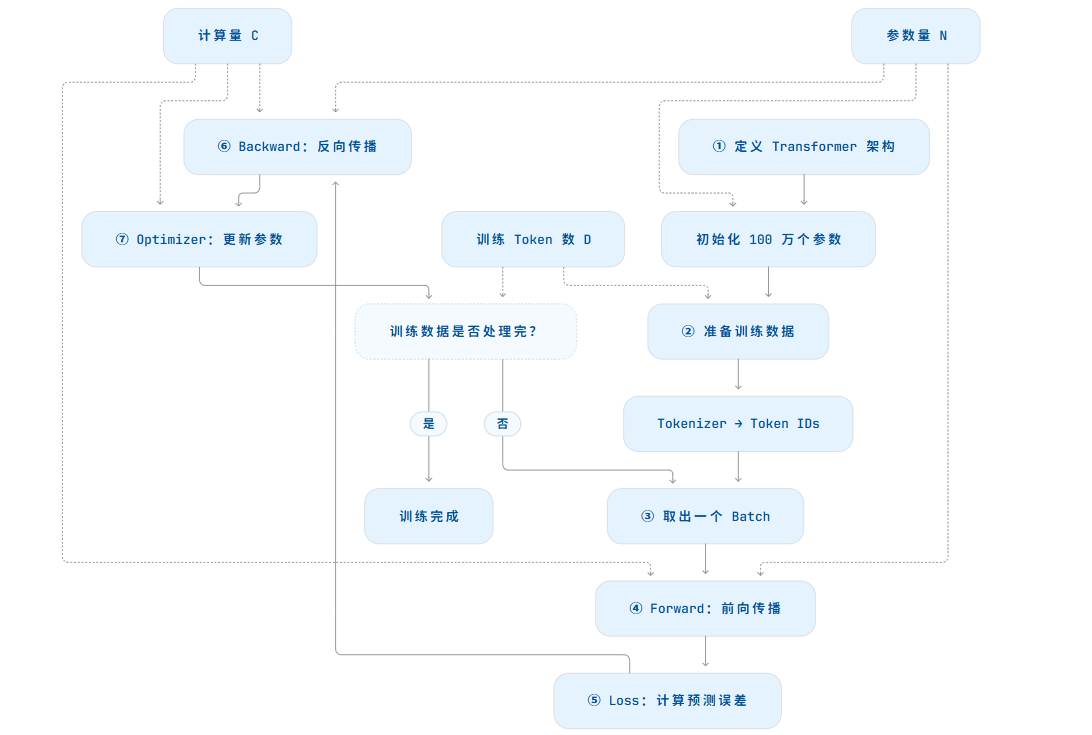
- Scaling Law(规模定律)的三个量化变量:参数量 (N)、训练 Token 数 (D)、训练计算量 (C)。
- 训练时的token数
- 数据三大黄金法则
- 数量
- 13B指的是130亿个参数
- 质量
- 数据集 A:包含大量广告、垃圾网页、重复文本和错误知识。
- 数据集 B:包含经过筛选的技术文档、教材、论文和高质量网页。
- 多样性
- 数量
- 表示模型学习到的知识量
- 训练 Token 数(Training Tokens)指的是训练过程中,模型实际处理的 Token 总量,而不是训练完成后模型生成的 Token 数。 / 更准确地说,它是原始文本经过 Tokenizer 分词、数据清洗等预处理后,实际送入模型训练的 Token 数量。
- 数据三大黄金法则
- 模型参数
- 13B表示130亿个参数
- 表示模型的学习能力
- FLOPs
- 计算资源
- 单位
- FLOP
- 完成特定任务所需的浮点运算总量
- FLOP
- 单位
- 表示训练成本
- 计算资源
- 训练时的token数
- 过程
- 规模法则
- 是什么
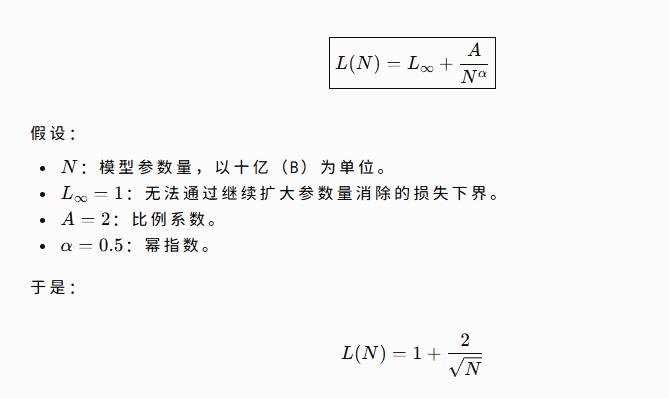
- 当模型参数量、训练数据量和计算量增加时,模型性能会按照什么规律变化。
- 给定算力预算,用于计算最佳规模和数据集大小的法则
- 公式
- 幂律
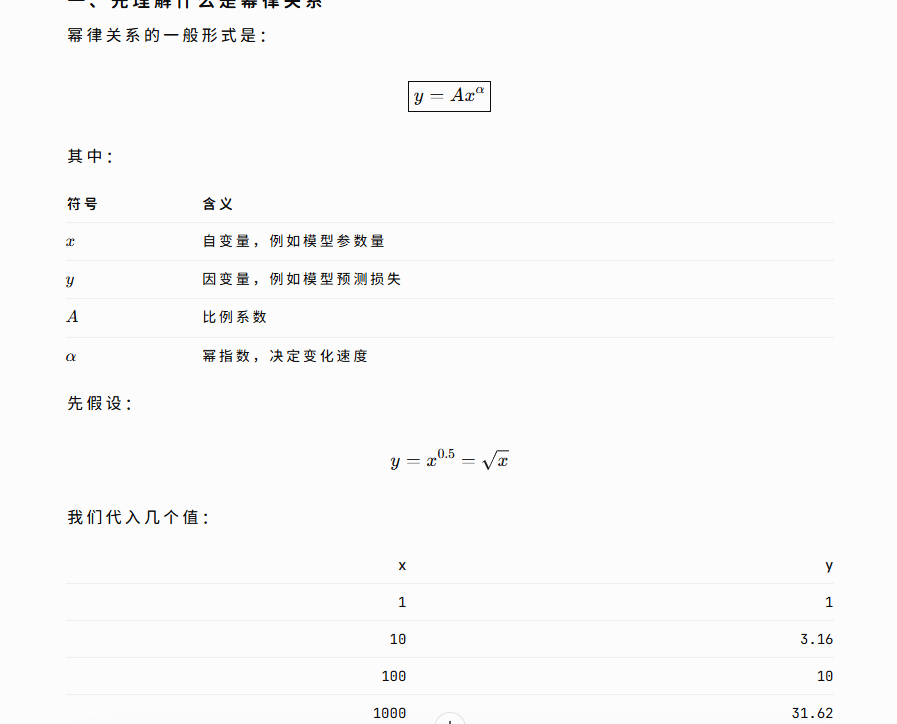
- 指数 α 决定变化速度
- 输入扩大 10 倍,输出变化 10^α 倍
- Subtopic 2
- 幂律
- 规模外推
- 超参数迁移
- 有10个超参数,就需要2的10次方组合
- 是什么
- 利用小模型实验发现的规律,预测更大模型的表现。
- 超参数迁移
- 瓶颈
- 数据瓶颈
- 高质量、合法可用且符合训练需求的数据是有限的,继续扩大数据规模的边际成本可能提高。
- 电力瓶颈
- 更大的模型 + 更多训练数据 / ↓ / 更多 FLOPs / ↓ / 更多 GPU 计算时间 / ↓ / 更高的用电与散热需求 / ↓ / 电网容量、机房散热、设备成本等限制
- 收益递减
- 假设你把计算预算增加 10 倍。 / 模型性能可能提高,但通常不会因此提高 10 倍。 / 例如,随着规模扩大,Loss 可能持续下降,但改善幅度逐渐变小。
- 数据瓶颈
- 价值
- 降低大规模训练方案选择的试错成本。
- 练一次成本非常高,不可能把所有参数量、数据量的组合都试一遍
- 降低大规模训练方案选择的试错成本。
- 是什么
- 三大要素
-
- 推理
- 生成与输出控制
- Sampling(采样)
- 问题
- 不一致性
- 相同的输入,不同的输出
- 缓存
- 随机种子
- 输入稍微相同,输出完全不一样
- 提示词
- 记忆系统
- 相同的输入,不同的输出
- 幻觉
- 原因
- 自我欺骗
- 自监督如何产生幻觉
- 标注员
- 监督如何产生幻觉
- 自我欺骗
- 原因
- 不一致性
- 是什么
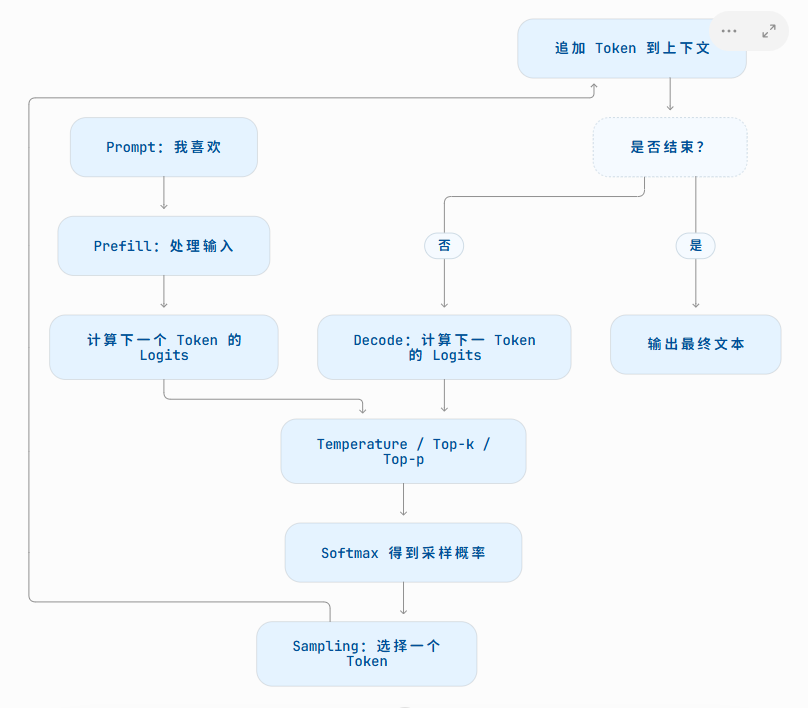
- 语言模型计算出下一个 Token 的概率分布后,按照一定策略,从候选 Token 中选出一个。
- Token / Logit(示例) / 概率 / 猫 / 2.30 / 60% / 狗 / 1.61 / 30% / 鸟 / 0.51 / 10%
- 语言模型计算出下一个 Token 的概率分布后,按照一定策略,从候选 Token 中选出一个。
- 为什么需要
- 模型只给出了下一个token的概率,但是选什么没有决定,所以需要策略
- 有哪些策略
- 贪心
- 每次选择概率最大的那个
- 随机
- 随机选一个
- 贪心
- 影响策略的参数
- 温度
- 降低常见token出现的概率,提高不常见的概率
- 温度实际作用于 Logits,再经过 Softmax,而不是直接随意修改概率。
- topk
- 选取排名前k的,其他对齐。剩下的继续归一化
- topp
- k的值是动态的
- 温度
- Subtopic 7
- 问题
- 生成控制
- Max New Tokens(最大生成长度)
- EOS(结束 Token)
- Stop Sequences(停止序列)
- 结构化输出
- 是什么
- 按照用户希望的格式输出数据
- 方法
- prompt
- 推理前 / 告诉模型按照指定格式输出
- 后处理
- 推理后 / 解析、修复或验证生成结果
- 推理时计算
- 推理过程中或之后 / 通过额外计算、重试、候选验证等提高格式正确率
- 约束采样
- Token 生成过程中 / 屏蔽不符合语法或 Schema 的候选 Token
- 微调
- 训练阶段 / 让模型学习遵循特定输出格式
- prompt
- 是什么
- Sampling(采样)
- 执行过程
- Prefill(预填充)
- 模型一次性处理已知输入 Token,计算上下文表示,并为后续生成准备缓存的阶段。
- 第一个token
- Prefill(预填充) / I love cat / │ │ │ / ▼ ▼ ▼ / x₁ x₂ x₃ / │ │ │ / └────────┼─────────┘ / ▼ / Transformer(因果注意力) / │ / ▼ / h₁ h₂ h₃ / │ / ├── 保存 KV Cache / │ / ▼ / 预测第一个新 Token
- 模型一次性处理已知输入 Token,计算上下文表示,并为后续生成准备缓存的阶段。
- Decode(逐 Token 解码)
- 利用已知上下文和此前生成的 Token,逐步计算下一个 Token 的过程。
- 后续token
- Decode / 第 1 轮: / 已有上下文:I love cat 我 / ↓ / Transformer / ↓ / Logits / ↓ / Sampling / ↓ / 喜欢 / 第 2 轮: / 已有上下文:I love cat 我 喜欢 / ↓ / Transformer / ↓ / Logits / ↓ / Sampling / ↓ / 猫 / 第 3 轮: / 已有上下文:I love cat 我 喜欢 猫 / ↓ / Transformer / ↓ / Logits / ↓ / Sampling / ↓ / 结束标记
- 利用已知上下文和此前生成的 Token,逐步计算下一个 Token 的过程。
- Prefill(预填充)
构建LLM的难度在
-
- 表达问题:什么样的数学函数能够表达现实规律? / 2. 优化问题:怎样高效找到这个函数的合适参数? / 3. 泛化问题:怎样保证它不仅适用于训练数据,还适用于未知数据? / 其中,Transformer 主要是对第一个问题提出了一个非常成功的解决方案,同时其架构特性也有利于第二个问题中的大规模训练。 / 所以,神经网络的基本训练算法不难理解,困难的是让这个算法在复杂模型、海量数据和有限计算资源下,真正学到能够泛化的规律。
如何优化
- Model Distillation(模型蒸馏)
- 是什么
- 也称Knowledge Distillation(知识蒸馏)
- 利用教师模型提供的监督信号训练学生模型,使学生模型学习教师模型的知识或行为
- 核心组成
- Teacher Model(教师模型)
- 提供目标行为或监督信号
- 通常是能力较强的模型
- Student Model(学生模型)
- 学习教师模型的知识或行为
- 通常是规模较小的模型
- Teacher Model(教师模型)
- 为什么需要
- 没有模型蒸馏
- 直接部署大模型的推理成本较高
- 小模型可能无法满足任务要求
- 人工构建高质量训练数据成本较高
- 引入模型蒸馏
- 利用教师模型的能力指导学生模型训练
- 使学生模型在目标任务上接近教师模型
- 降低推理成本和部署资源消耗
- 没有模型蒸馏
- 如何实现
- 整体流程
- 确定目标能力 → 选择教师与学生模型 → 获取教师监督信号 → 训练学生模型 → 评估蒸馏效果
- 主要方法
- 响应蒸馏
- 教师模型生成目标响应
- 验证生成数据
- 使用数据对学生模型进行SFT
- Logit蒸馏
- 获取教师模型的输出概率分布
- 训练学生模型拟合教师模型的输出分布
- 响应蒸馏
- 训练方式
- 从头训练学生模型
- 基于预训练模型进行微调
- 整体流程
- 如何评估
- 目标任务表现
- 与教师模型的性能差距
- 推理延迟
- 推理成本
- 泛化能力与长尾场景表现
- 局限
- 不保证学生模型达到教师模型的全部能力
- 可能继承教师模型的错误
- 教师监督信号质量影响蒸馏效果
- 需要遵守模型输出数据的使用许可
- 与数据合成的关系
- 数据合成
- 负责生成训练数据
- 模型蒸馏
- 负责将教师模型的能力迁移到学生模型
- 两者可以组合
- 教师模型生成数据 → 验证数据 → 训练学生模型
- 不是所有使用合成数据的训练都属于蒸馏
- 数据合成
- 是什么
拖动可平移,滚轮缩放,点击节点可展开或折叠。大型导图默认折叠较深层级,可点击节点继续展开。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看