
NOTE
2.10 如何设计容错组件
1. 什么是容错 微服务架构下,如果一个服务故障了,那么会影响到整个链路,导致服务整体不可用 2. 为什么需要容错 确保服务的可用性,防止雪崩效应 2.1. 服务雪崩 多个微服务之间调用的时候,假设服务A调用服务B和C,服务B调用服务D和E,服务C调用服务F和服务G...这就叫 扇出 因“服务提供者
这是历史学习笔记,可能存在过时或不完整的理解。
1. 什么是容错
微服务架构下,如果一个服务故障了,那么会影响到整个链路,导致服务整体不可用
2. 为什么需要容错
确保服务的可用性,防止雪崩效应
2.1. 服务雪崩
多个微服务之间调用的时候,假设服务A调用服务B和C,服务B调用服务D和E,服务C调用服务F和服务G…这就叫扇出 因“服务提供者的不可用”(原因)导致“服务调用者不可用”(结果),并将不可用逐渐放大的现象。换句话说,扇出链路上某一个服务失败,导致整条链路的服务都失败的情形
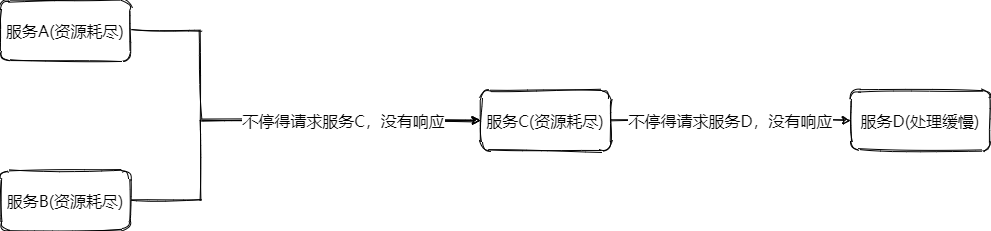
如图,服务C调用服务D,如果服务D出问题一直没有返回(响应时间过长或者不可用),服务C继续调用服务D,服务D还是没有返回…继续重试直至服务C的线程资源耗尽时无法提供其他服务,调用服务C其他接口的服务A和B也因此受到影响,最后影响到整个微服务系统
3. 如何设计容错组件
3.1. 超时
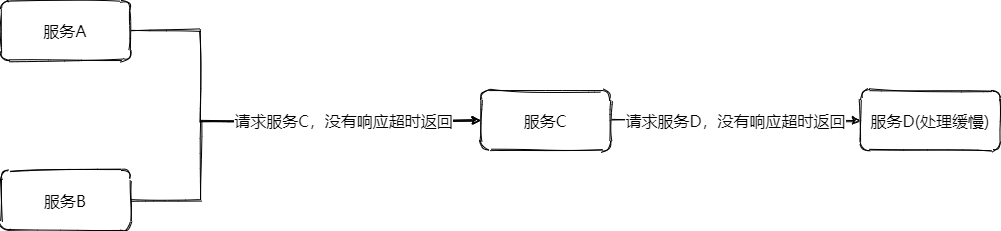
- 为了防止服务C请求服务D但是一直没有响应,导致服务C的线程等资源一直hold着无法释放,因此需要设置超时
- 一般HTTP和RPC框架都有超时设置,比如context.md
3.2. 重试
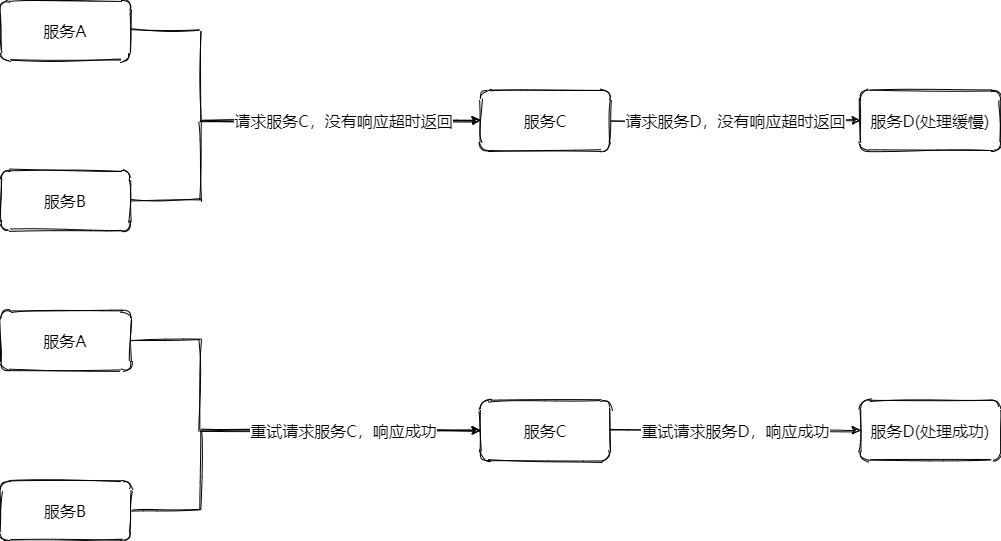
- 如果服务C请求服务D发生了网络错误,那么会触发超时,但是这个网络是暂时的,因此重试几次可能就好了
- 比如retry.md
3.3. 限流
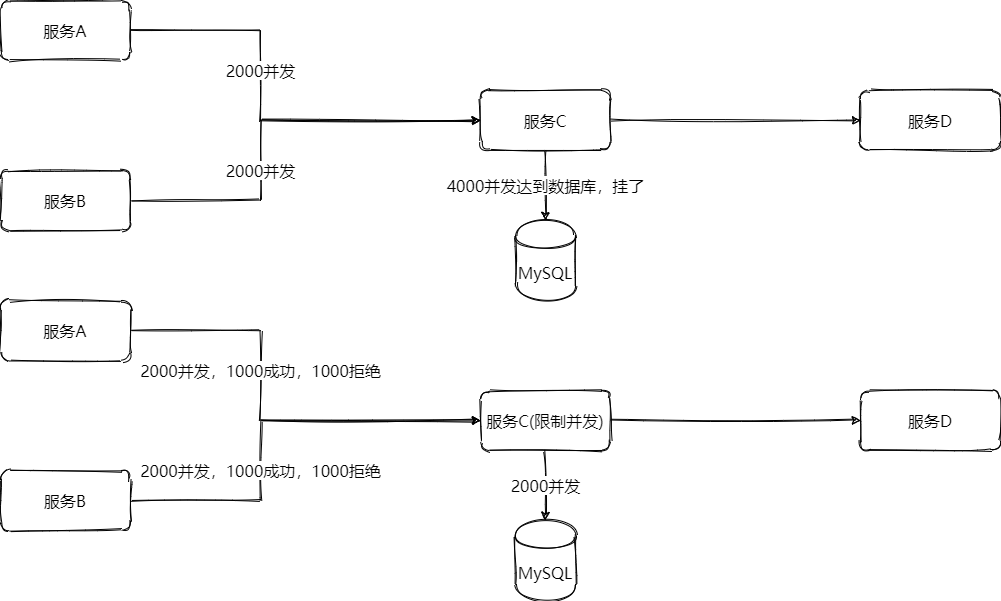
- 如果服务C访问了数据库,假设每秒最多2000并发,此时服务A和服务B各2000并发打过来,那么服务C就挂了。因此需要限制C的并发数,多余的拒绝
- 如何设计一个限流系统.md
3.4. 熔断
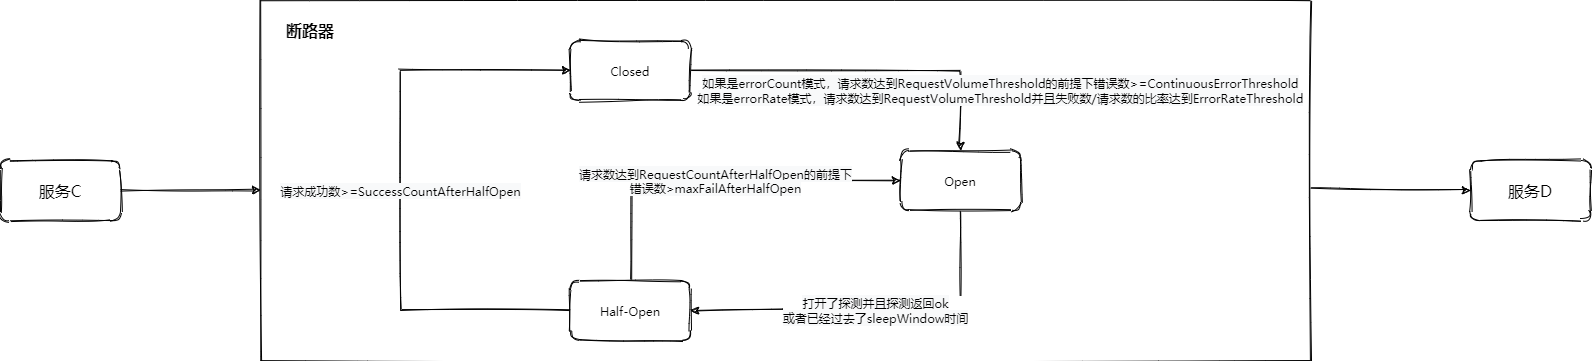
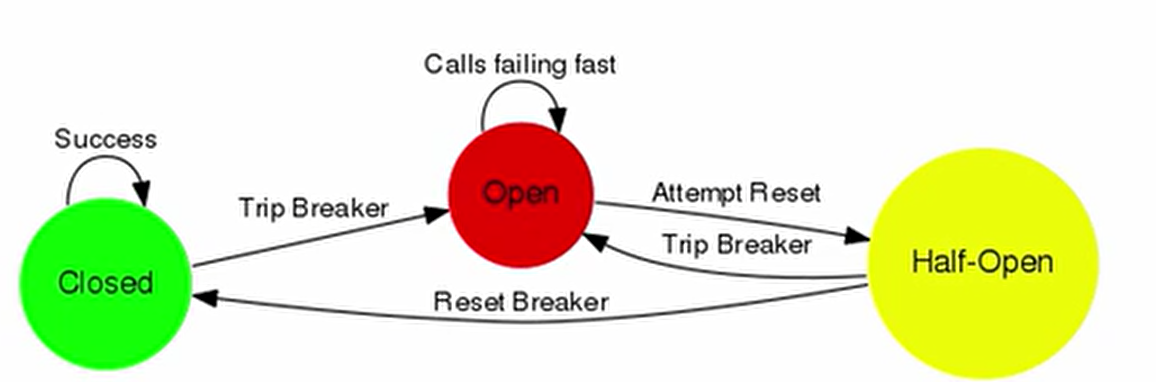
- 错误数达到阈值时不再调用目标模块,好转则恢复调用
- 当下游的服务因为某种原因突然变得不可用或响应过慢,上游服务为了保证自己整体服务的可用性,不再继续调用目标服务,直接返回,快速释放资源。
- 如果目标服务情况好转则恢复调用。
- 即断路器模式
3.5. 隔离
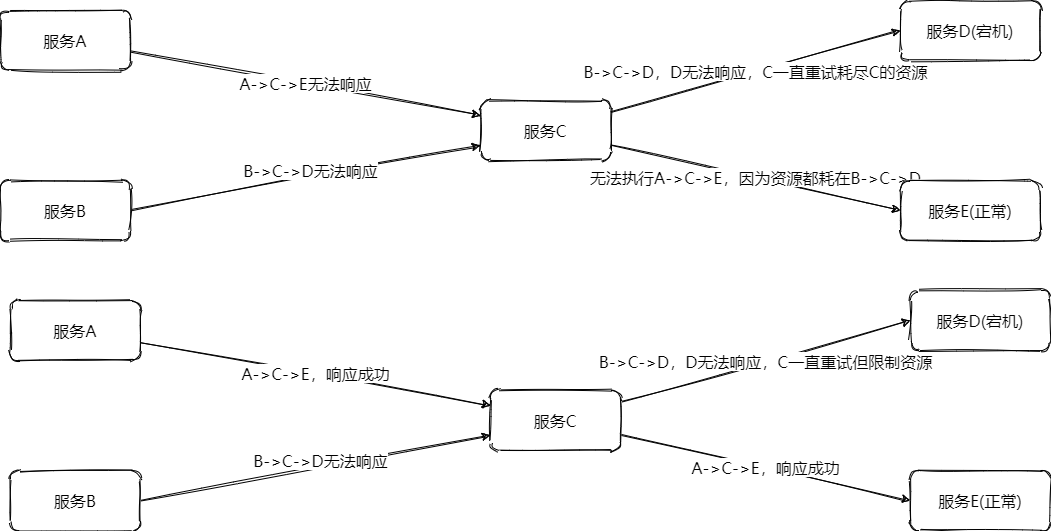
- 服务C请求服务D和服务E,如果服务D挂了,那么服务C会一直超时重试,那么服务C的线程等资源都hold在服务D了,没法请求服务E。因此需要隔离C->D和C->E的资源
- 即舱壁隔离模式
3.6. 降级
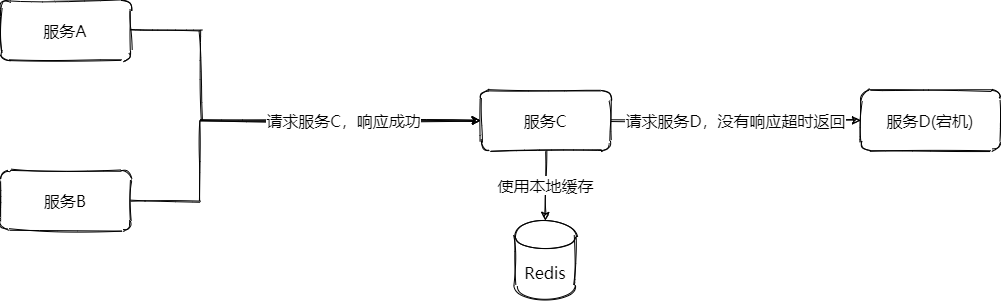
- 上游服务调用下游服务,当下游服务不可用或响应过慢,执行上游服务本地的备用方案
- 自定义处理
- fail-fast
- fail-silent
- 服务C调用服务D,服务D挂了,那么可以使用服务C的本地缓存
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看