
NOTE
缓存
CPU Cache、MESI、写缓冲器、无效化队列与内存屏障的历史学习笔记。
这是历史学习笔记,可能存在过时或不完整的理解。
[toc]
1. 高速缓存
CPU和内存之间有一层高速缓存,用于弥补两者之间速度的差异。
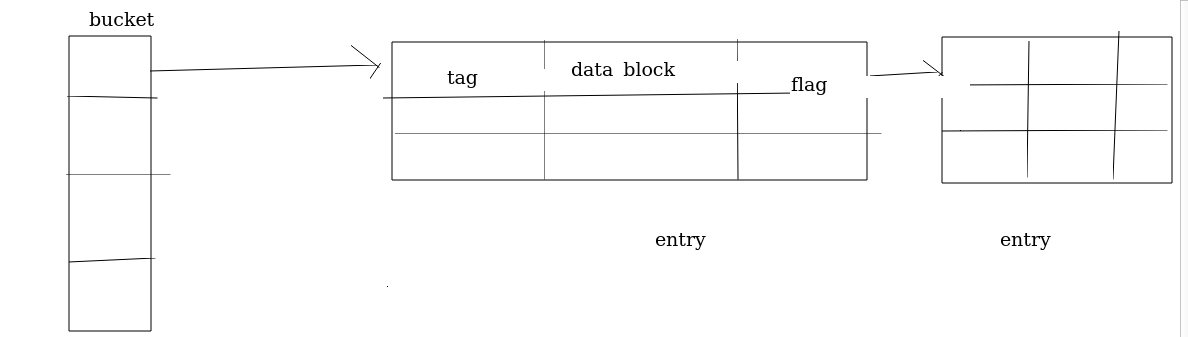 在典型的组相联高速缓存中,内存地址可以分为 index、tag、offset 三部分。
首先通过 index 确定 cache set
然后通过 tag 确定 cache line
再通过 offset 确定 cache line 中的具体字节
最后根据 valid 等状态位判断该 cache line 是否有效
1.1. 高速缓存带来的问题
多个处理器 Core 可能同时缓存同一个内存位置。某个时刻 Core A 更新了这个数据,其他 Core 如何得知? 这就需要引入缓存一致性协议。
2. 缓存一致性
2.1. MESI协议
MESI 把缓存行分成四种状态:
- Invalid 当前缓存行无效。
- Shared 多个处理器可能缓存同一行,缓存数据与内存一致。
- Exclusive 只有当前处理器缓存该行,缓存数据与内存一致。
- Modified 当前处理器已经修改该缓存行,主存中的副本可能已经过期。
2.1.1. 具体实现
- Processor0需要读取数据S,状态为I。Processor1状态为M/E/S。 Processor0发出 Read 请求。如果其他处理器以 M 状态持有最新数据,由一致性协议提供最新数据并转换状态;否则可以从其他缓存或内存读取。
- Processor0需要写入数据S。 如果状态为M,可以直接写入。 如果状态为E,可以直接写入并把状态改为M。 如果状态为S,需要先取得独占所有权并使其他共享副本失效,再写入并改为M。 如果状态为I,需要先取得该缓存行和独占所有权,再写入并改为M。
- 总结 MESI采用 write-invalidate。典型缓存通常使用 write-back,并不是每次写入都会立即写回内存。
2.1.2. MESI的性能问题
当缓存行处于共享状态时,写入方需要先取得独占所有权并使其他副本失效,这会产生一致性通信和等待开销。
3. 写缓冲器和无效化队列
3.1. 写缓冲器
写缓冲器是处理器写路径上的暂存结构。 当写入还需要等待缓存一致性事务完成时,数据可以先进入写缓冲器,处理器继续执行后续指令。
总结 处理器执行写入后,其他处理器不一定能够立刻观察到这个写入。
3.2. 无效化队列
其他处理器收到 Invalid 消息后,可以先把消息排入无效化队列再处理;是否以及何时提前回复取决于具体实现。
3.3. 带来的问题
可见性和重排序
4. 重排序问题
写缓冲器、乱序执行等机制可能使内存操作被其他处理器观察到的顺序与程序顺序不同。
4.1. 分类
StoreLoad Store 之后的 Load 可能被观察为先于该 Store 生效。
StoreStore 两个 Store 的可观察顺序可能发生变化。
LoadLoad 两个 Load 的可观察顺序可能发生变化。
LoadStore Load 与后续 Store 的可观察顺序可能发生变化。
具体允许哪些重排序取决于处理器架构和内存模型。
5. 可见性问题
一个处理器已经执行写入,但该写入尚未变成其他处理器可观察的状态时,其他处理器仍可能读到旧值,这里讨论的就是可见性问题。
5.1. 解决
使用同步原语或内存屏障建立所需的内存访问顺序。
6. 内存屏障
内存屏障用于限制某些内存操作跨越屏障被重排序,或者被其他处理器以不符合要求的顺序观察。 可以用 XY 表示一类顺序约束:屏障前的 X 类型访问不能越过屏障,被观察为发生在屏障后的 Y 类型访问之后。
6.1. 具体实现
不同处理器架构提供的 Fence / Barrier 指令和保证不同。 内存屏障不能简单理解为“清空无效化队列”或“把写缓冲器全部 flush 到高速缓存或内存”。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看