
并发编程(一):先谈硬件——从 count++ 到原子性、可见性与有序性
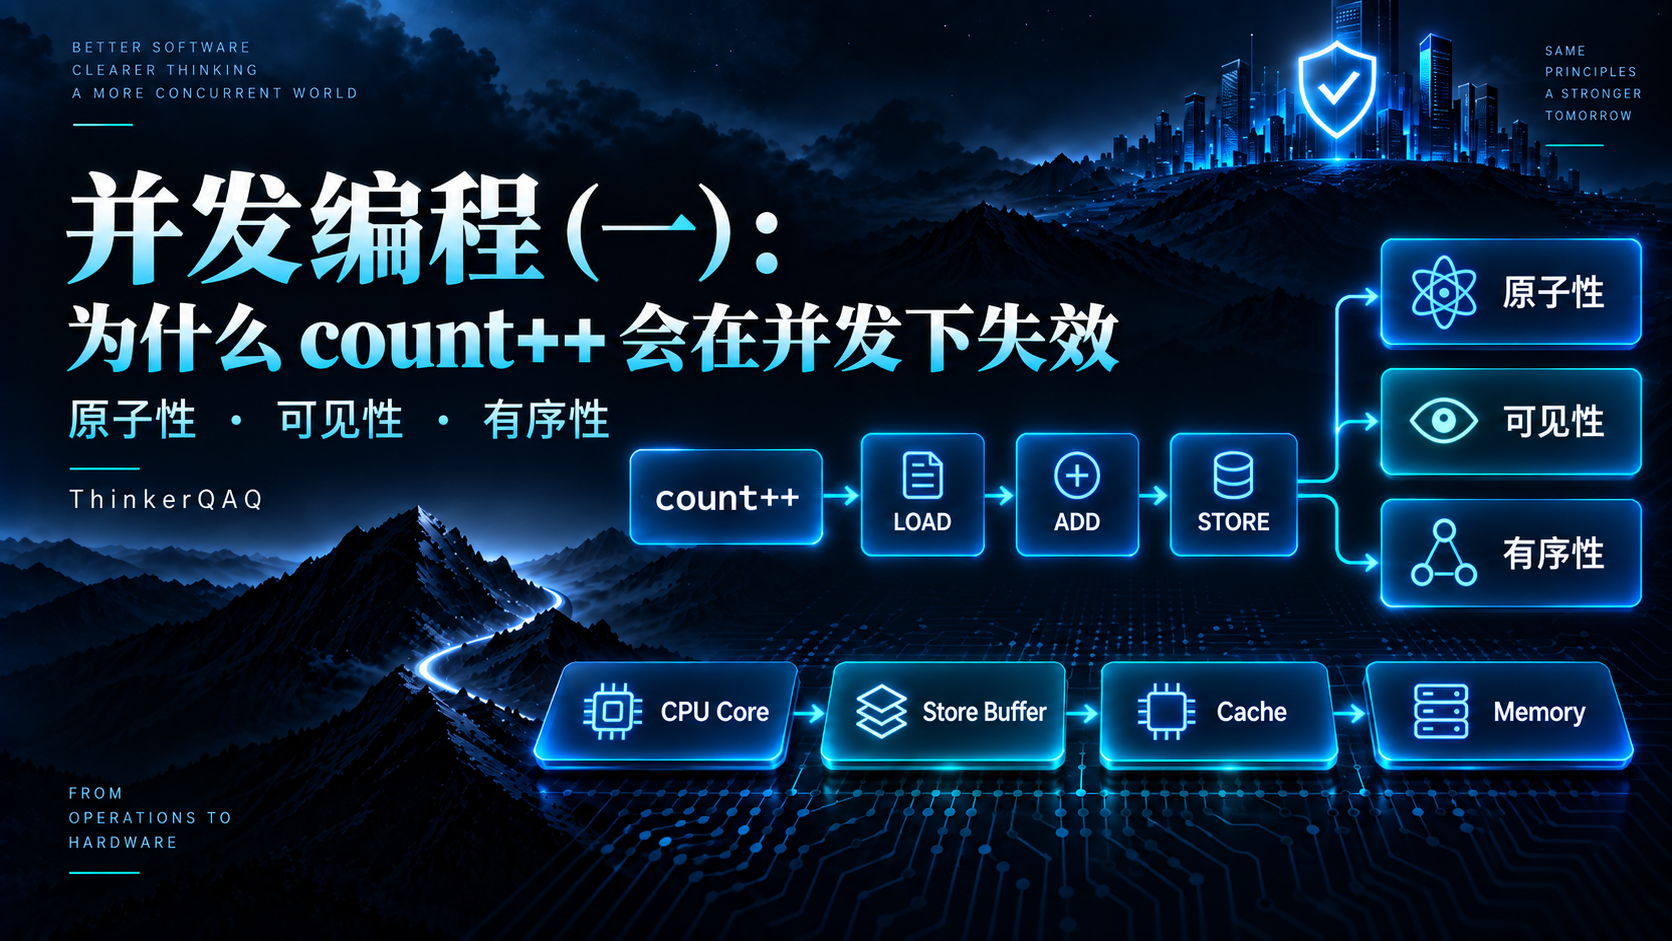
从冯·诺依曼体系结构和指令执行过程出发,沿着 count++ 分析硬件层面的原子性、可见性与有序性问题。
目录
- 1. 从冯诺依曼体系结构说起
- 2.
count++最终会变成什么? - 3. 为什么需要 Cache?
- 4. 单核下的并发问题:为什么
count++会丢失更新? - 5. 从单核走向多核:可见性问题
- 6. 多个内存操作之间的顺序又怎么办?
- 7. 到这里,我们实际上遇到了三个问题
- 8. 硬件如何回答这三个问题?
- 9. 总结
这一篇继续沿用 count,只关注硬件层:
CPU 和内存系统到底会带来哪些并发问题,硬件又提供了什么能力?
1. 从冯诺依曼体系结构说起
冯诺依曼提出将程序当作数据对待,把程序(指令)和数据用同样的方式存储。根据这个理论,计算机可以分成控制器、运算器、存储器、输入设备和输出设备。
运算器和控制器组成 CPU,CPU 内部还有寄存器。其中,Program Counter(PC,程序计数器)保存下一条指令的地址;Instruction Register(IR,指令寄存器)保存当前正在处理的指令;R1 这样的通用寄存器用于保存数据和中间结果。
┌──────────────────┐                    ┌──────────────────┐
│     输入设备     │                    │     输出设备     │
└─────────┬────────┘                    └─────────▲────────┘
          │                                       │
          └───────────────────┬───────────────────┘
                              │
                           系统总线
                              │
             ┌────────────────┴─────────────────┐
             │                                  │
             ▼                                  ▼
┌────────────────────────┐         ┌────────────────────────┐
│         CPU         │         │         存储器         │
│                        │         │                        │
│         控制器         │         │     程序指令+数据     │
│         运算器         │         │                        │
│         寄存器         │         │                        │
│    PC/IR/R1    │         │                        │
└────────────────────────┘         └────────────────────────┘
CPU 执行一条指令的过程可以简化为:
        ┌───────────────────────────────┐
        │                               │
PC 给出下一条指令地址                    │
        ↓                               │
Fetch:从内存取出指令                    │
        ↓                               │
IR:保存当前指令                         │
        ↓                               │
Decode:译码当前指令                     │
        ↓                               │
Execute:执行当前指令                    │
        ↓                               │
PC 指向下一条指令 ───────────────────────┘
2. count++ 最终会变成什么?
程序里的 count++ 最终也要转换成机器指令,然后每一条机器指令分别经历上一节的执行循环。
为了便于讨论,可以把 count++ 简化成三条机器指令:
LOAD  R1, [count]    // 把 count 读入寄存器 R1
ADD   R1, 1          // 在 CPU 内部把 R1 加 1
STORE [count], R1    // 把结果写回 count
把它和上一节的指令执行循环连起来,可以理解为:
count++
        ↓ 编译 / 翻译后的简化表示

LOAD  R1, [count]
ADD   R1, 1
STORE [count], R1

        ↓ 每条机器指令分别经历上一节的执行循环

PC → LOAD 所在的指令地址
Fetch LOAD
IR ← LOAD R1, [count]
Decode LOAD
Execute LOAD

        ↓

PC → ADD 所在的指令地址
Fetch ADD
IR ← ADD R1, 1
Decode ADD
Execute ADD

        ↓

PC → STORE 所在的指令地址
Fetch STORE
IR ← STORE [count], R1
Decode STORE
Execute STORE这里值得关注的是,LOAD 和 STORE 都需要访问内存数据。于是下一个问题自然出现:
如果每一次 LOAD / STORE 都要直接等待内存,会发生什么?
3. 为什么需要 Cache?
CPU 的执行速度远高于内存访问速度。如果每次 LOAD 都要等待内存返回数据,每次 STORE 都要等待内存完成写入,CPU 会浪费大量时间。
因此,现代处理器会在 CPU Core 和内存之间设置更快、容量更小的多级 Cache。下面是一个简化结构,具体层级以及哪些 Cache 由多个 Core 共享,取决于处理器设计:
CPU
 │
 ▼
L1 Cache
 │
 ▼
L2 Cache
 │
 ▼
L3 Cache
 │
 ▼
Memory
CPU 访问 count 时,通常会把包含它的整个 Cache Line 加载到 Cache。这里仍简化写成:
CPU
 │
 ▼
Cache:count = 0
 │
 ▼
Memory:count = 0
之后 CPU 再访问 count 时,就可能直接命中 Cache,而不必每次都访问内存。
所以:
Cache 解决的是 CPU 与内存之间的速度差距。 也就是性能问题。
很多并发问题都和缓存有关,但这里先不扩展,我们先直接进入到并发问题
4. 单核下的并发问题:为什么 count++ 会丢失更新?
假设机器只有一个 CPU Core:
Thread A ──┐
           │
           ├──> Core 0 ──> Cache ──> Memory
           │
Thread B ──┘
两个线程不能在这个 Core 上真正同时执行,但它们可以交替执行。
仍然从:
count = 0开始。
Thread A                              Thread B
   │                                    │
   ├─ LOAD count -> 0                   │
   │                                    │
   ├─────── context switch ────────────>│
   │                                    ├─ LOAD  count -> 0
   │                                    ├─ ADD   1
   │                                    ├─ STORE count -> 1
   │                                    │
   │<────── context switch ─────────────┤
   ├─ ADD   1                           │
   ├─ STORE count -> 1                  │
线程切换时,操作系统会保存 Thread A 的执行上下文,包括它已经读到的中间结果。Thread A 恢复执行后,仍然会基于之前读到的 0 继续计算。
最终:
count = 1原因是
LOAD
ADD
STORE
不是一个不可分割的整体。
只要一个执行单元进行到一半时,另一个执行单元插进来,就可能出现 丢失更新。
于是得到第一个问题:
问题一:一个复合操作如何不可分割地完成?
也就是:
Atomicity这里先不回答。
继续往下看多核又会新增什么问题。
5. 从单核走向多核:可见性问题
如果处理器拥有多个 CPU Core,那么两个线程可能真正同时执行:
Thread A                       Thread B
   │                              │
   ▼                              ▼
Core A                         Core B
   │                              │
   ▼                              ▼
Cache A                        Cache B
   │                              │
   └──────────────┬───────────────┘
                  ▼
                Memory
单核下的 count++ 并发问题仍然存在。
但多核还会带来一个新的问题。
假设:
count = 0Core A 和 Core B 都读取过 count。
那么同一份数据可能同时存在于不同 Cache 中:
Core A Cache                    Core B Cache
count = 0                       count = 0

               Memory
              count = 0
现在 Core A 修改 count:
Core A Cache                    Core B Cache
count = 1                       count = 0
于是问题来了:
Core B 手里的旧副本还能不能继续使用?
也就是说:
问题二:一个 Core 修改数据后,其他 Core 什么时候能够观察到新的值?
即
Visibility这里仍然先不回答。
继续看第三类问题。
6. 多个内存操作之间的顺序又怎么办?
继续沿用前面的 count 例子:
count = 0
ready = false
Thread A Thread B
│ │
├─ count = 1 ├─ 读取 ready
└─ ready = true └─ 如果为 true,读取 count程序员自然会希望:
如果 Thread B 已经看到
ready = true,那么它也应该看到前面写入的count = 1。
也就是说,我们希望 B 只出现下面两种结果:
结果一:

Thread A                         Thread B

                                 读取 ready -> false
                                 不进入 if

结果二:

Thread A                         Thread B

count = 1
ready = true                     读取 ready -> true
                                 进入 if
                                 读取 count -> 1
                                 打印 1
而不是第三种结果:
Thread A                         Thread B

count = 1
(这个写入尚未被 B 观察到)
ready = true                     读取 ready -> true
                                 进入 if
                                 读取 count -> 0
                                 打印 0
也就是说
当 B 已经读到
ready = true时,如何保证它不能再读到旧的count = 0?
但这里已经不是:
同一个 count 的多个缓存副本而是两个不同的内存位置:
count
ready
以及两个内存操作:
count = 1
ready = true
之间的关系。
于是出现第三个问题:
问题三:多个内存操作允许按照什么顺序被其他 Core 观察?
也就是:
Memory Ordering为什么硬件会让这个问题变复杂?
还是那句话,现代 CPU 为了性能,会引入各种优化机制。
6.1 Store Buffer
继续沿用 count++。假设 count = 0,Core A 执行:
LOAD  count -> 0
ADD   1     -> 1
STORE [count], 1其中,STORE 写入的 count = 1 可能先进入 Store Buffer,如下:
CPU(Core)
    │
    ▼
Store Buffer
    │
    ▼
Cache
    │
    ▼
Memory
注意:Store Buffer 和 Cache 不是同一个东西。 Store Buffer 是 Core 写路径上的暂存结构;Cache 保存的是缓存数据。为方便讨论,我们继续简化如下:
CPU(Core A)
执行 STORE [count], 1
        │
        ▼
Store Buffer
暂存 count = 1
        │
        ▼
Memory
在 Store Buffer 中的写入对其他 Core 可见之前,Core A 已经可以继续执行:
初始:count = 0

Core A                               Core B
   │                                    │
   ├─ LOAD  count -> 0                  │
   ├─ ADD   1     -> 1                  │
   ├─ STORE count -> 1                  │
   │  写入 Store Buffer                 │
   ├─ 继续执行后面的指令                │
   │                                    ├─ LOAD count -> 0
   │                                    │  仍然读到旧值
   └─ count = 1 对外可见                │
6.2 Out-of-Order Execution
现代 CPU 还会为了充分利用执行单元,在不破坏必要依赖关系的前提下调整内部执行顺序。
只要不改变当前线程自己的执行结果,这种调整本身没有问题。问题仍然出在多个 Core 之间。
继续沿用前面的 count 发布例子:
Thread A / Core A                 Thread B / Core B

count = 1                        if ready {
ready = true                         print(count)
                                 }
从源码顺序看,A 先写 count,再写 ready。但是在没有额外顺序约束、并且硬件允许这种内存顺序时,可能出现:
初始:count = 0,ready = false

Thread A / Core A                 Thread B / Core B
   │                                  │
   ├─ STORE count = 1                 │
   │  尚未被 Core B 观察到            │
   ├─ STORE ready = true              │
   │                                  ├─ LOAD ready -> true
   │                                  └─ LOAD count -> 0
也就是说,A 的源码先写了 count,B 却先观察到 ready = true,随后仍读到旧的 count = 0。
其他 Core 被允许以什么顺序观察这些内存操作?
6.3 Store Buffer vs Out-of-Order Execution
这两个机制容易混淆,可以直接对比它们分别回答什么问题:
| 概念 | 它回答的问题 |
|---|---|
| Store Buffer | 一条 STORE 已经由当前 Core 执行后,为什么其他 Core 还可能暂时看不到? |
| Out-of-Order Execution | 为什么源码靠后的指令可能在 Core 内部更早执行? |
但共同点是它们都可能影响其他 Core 最终观察到的内存顺序。
7. 到这里,我们实际上遇到了三个问题
前面的问题可以归纳成三类:
| 问题 | 问题表现 | 硬件需要回答什么 |
|---|---|---|
| Atomicity(原子性) | A、B 都执行 count++ 时,可能都读到 0,最后都写回 1 |
哪些操作对其他执行单元表现为不可分割? |
| Visibility(可见性) | Core A 已经通过 count++ 把 count 写成 1,Core B 仍可能读到缓存中的 0 |
一个 Core 写入后,其他 Core 什么时候能够观察到? |
| Ordering(有序性) | Core A 先完成 count++,再写入 ready = true;Core B 却可能先读到 ready = true,随后仍读到 count = 0 |
多个 Memory 操作允许以什么顺序被其他 Core 观察?? |
接下来分别看硬件提供了哪些基础能力:
现代硬件分别提供了什么机制来处理这三个问题?
8. 硬件如何回答这三个问题?
8.1 Atomicity:Atomic Instruction
普通的 LOAD + ADD + STORE 是多个步骤。如果希望 Read-Modify-Write 对其他执行单元表现为不可分割的整体,就需要硬件提供原子操作,例如:
Compare-And-Swap
Exchange
Fetch-And-Add
这些操作在处理器内部不一定只包含一个微小步骤。“原子”描述的是它们对其他执行单元的可观察结果:
┌──────────────────┐
│ 读取旧值         │
│     │            │
│     ▼            │
│ 修改             │
│     │            │
│     ▼            │
│ 写入新值         │
└────────┬─────────┘
         │
         └── 对竞争者表现为一个不可分割的原子操作
回到 count++。如果语言把自增实现为硬件支持的原子 Read-Modify-Write,那么执行过程可以理解为:
初始:count = 0

Thread A                         Thread B

原子地把 count 从 0 改为 1
                                 原子地把 count 从 1 改为 2

最终:count = 2
A 和 B 谁先执行并不重要。每次原子更新必须基于某个确定的旧值完成,因此不会再出现两边都读取 0、最后都写入 1 的情况。
8.2 Visibility:Cache Coherence
多核处理器通过 Cache Coherence Protocol 协调多个 Core 对同一个内存位置的缓存副本。
MESI 是最经典的缓存一致性协议之一:
M - Modified
E - Exclusive
S - Shared
I - Invalid
真实处理器中也会使用 MESI 或它的扩展、变体,例如:
MESI
MOESI
MESIF
...
本文不展开状态机的所有转换,只看它解决的问题。
假设两个 Core 都缓存了包含 count 的 Cache Line:
Core A Cache              Core B Cache

count = 0                 count = 0
Shared                    Shared
如果 Core A 需要修改它:
count = 1硬件需要先协调这个 Cache Line 的所有权和其他副本状态。
可以简化理解为:
Core A 要修改 count
        │
        ▼
取得对应 Cache Line 的写权限
        │
        ▼
其他不能继续使用的副本失效
        │
        ▼
Core A 完成修改
Core A 获得写权限后,Core B 缓存中的 count = 0 会失效,下一次读取 count 时不能再使用这个旧值。
8.3 Memory Ordering:Fence
假设 count = 1 尚未被 B 观察到,在允许这种结果的硬件上可能出现:
Thread A / Core A                       Thread B / Core B
|                                       |
+-- STORE count = 1                     |
+-- STORE ready = true                  |
|                                       +-- LOAD ready -> true
|                                       +-- LOAD count -> 0
要阻止这种结果,需要用 Fence 约束两侧内存操作的顺序:
Thread A / Core A                       Thread B / Core B
|                                       |
+-- STORE count = 1                     |
+-- FENCE                               |
+-- STORE ready = true                  |
|                                       +-- LOAD ready -> true
|                                       +-- FENCE
|                                       +-- LOAD count -> 1
写入侧的 Fence 保证 count = 1 不能排到 ready = true 之后;读取侧的 Fence 保证对 count 的读取不能排到对 ready 的读取之前。
Fence 不保证 B 一定读到 ready = true。但当 B 已经读到 ready = true 时,随后读取 count 不能再得到旧值 0。
9. 总结
硬件针对三个并发问题提供了不同的基础能力:
| 问题 | 硬件提供的能力 |
|---|---|
| Atomicity(原子性) | Atomic Instruction:提供原子 Read-Modify-Write(例如 Compare-And-Swap),让一次更新对竞争者表现为不可分割的整体,竞争者无法观察到中间状态。 |
| Visibility(可见性) | Cache Coherence:协调多个 Core 对同一 Cache Line 的缓存副本,使某个 Core 完成写入后,其他 Core 不会继续使用已经失效的旧值。 |
| Ordering(有序性) | Fence:约束相关 Load / Store 的顺序,避免其他 Core 以程序不允许的顺序观察这些内存操作 |
下一篇:《并发编程(1.5):操作系统层》,继续讨论 Thread 和 Goroutine 如何获得 CPU 时间。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看