
NOTE
2.1 如何设计Feed流系统
Feed 流系统设计学习笔记,比较 Pull、Push 与混合 Fan-out 的读写扩散方案。
这是历史学习笔记,可能存在过时或不完整的理解。
1. 需求是什么
只要大拇指不停地往下划手机屏幕,就有一条条的信息不断涌现出来
2. 为什么要做这个需求
3. 需求分析
4. 方案设计
4.1. 存储设计
根据功能要求、请求量、数据量、存储模型等决定使用那种存储
- 功能
- Redis:快
- Kafka:削峰异步解耦
- 请求量
- C端
- 数据量
- 每天数据量=每天请求量*每次请求数据写入量
- 保存多少天
- 数据模型设计
- 博主博文列表
- 博主的粉丝列表
- 粉丝关注的博主列表:
- 粉丝关注的博主的博文列表
4.2. 接口设计
4.2.1. 博主发布博文
- Req
- content
- Rsp
- code
- msg
4.2.2. 粉丝拉取关注的博主的博文列表
- Req
- page
- page_size
- Rsp
- code
- msg
- total_page
- blog list
- uid
- content
- createtime
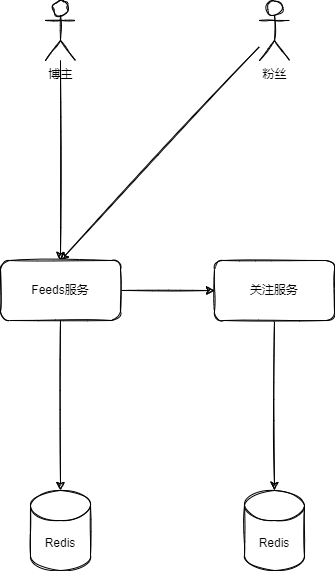
4.3. 架构设计
4.3.1. Pull vs Push
- Pull
- 粉丝阅读的时候,遍历他关注的人,取出帖子进行聚合
- 这种方式也叫读扩散:读一次Feed流,后台会扩散为N次读操作(N等于关注的人数)以及一次聚合操作,因此称为读扩散
- 优点:不会浪费额外空间
- 缺点:读操作很重,需要读N次再聚合;关注人数多时是灾难
- 使用场景:关注人数不多
- Push
- 发布者发表帖子的时候,遍历关注他的粉丝,把帖子写进去
- 这种方式也叫写扩展:每次发表帖子,都会扩散为M次写操作(M等于自己的粉丝数),因此成为写扩散
- 优点:读很快
- 缺点:数据冗余;粉丝量多时是灾难
- 使用场景:粉丝人数不多
- Pull + Push
- 粉丝量很小的采用写扩散,遍历所有粉丝将帖子写入信箱
- 粉丝量很大的采用读扩散,然后活跃的粉丝则使用写扩散
- 总结:一个是哪些用户属于大V,我们可以将粉丝量作为一个判断指标。另一个是哪些用户属于活跃粉丝,这个判断标准可以是最近一次登录时间等
4.4. 代码设计
5. 工作量评估
- 一个接口评估0.5-2天
6. 开发
7. 测试
功能测试、单元测试、接口测试、压力测试等 测试.md
8. 运维
- 上线部署
- 部署图.md
- 机器数目:可以估算整个系统的请求量,然后二八原则来估算实际QPS,再除以压测出来的QPS
- 梳理核心链路日志和监控
9. 总结
- 方案对比
- 遇到的问题以及怎么解决的
- 设计中的亮点
- 为什么引入XXX组件
- 痛点梳理与改进措施
- 请求量、数据量扩大N倍怎么处理
- 重构.md
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看