
并发编程(二):语言内存模型——程序员可以依赖的规则
从硬件内存模型回到语言层,理解语言为什么需要定义内存模型,以及 Java、Go 与 CPython 分别为并发程序提供哪些基本保证。
目录
0. 从上一篇继续
上一篇《并发编程(1.5):操作系统层》解释了执行单元如何获得 CPU 时间,本篇转向并发读写的语言规则。
1. 为什么语言需要内存模型层?
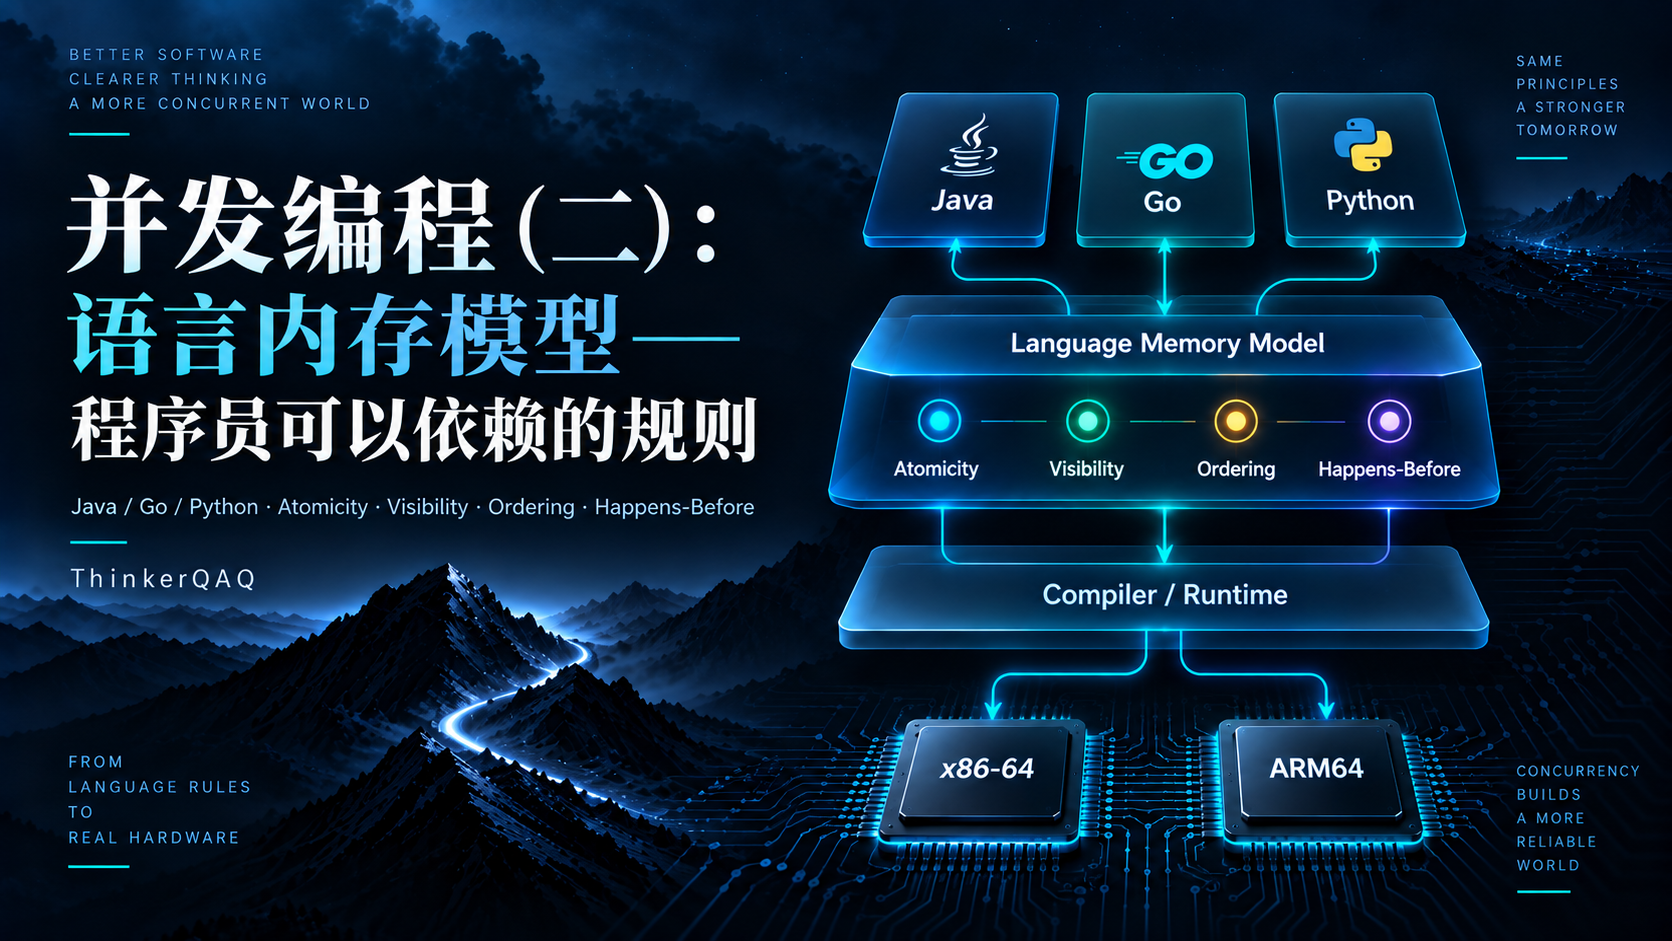
源代码需要经过编译器和 Runtime,最终才能在 CPU 上执行。编译器会优化代码,x86-64、ARM64 等处理器允许的内存访问顺序也不完全相同。
如果程序员必须分别研究每一种编译器、Runtime 和 CPU,跨平台并发编程就很难成立。
因此还需要一层语言内存模型层,由它定义规则,程序员只需要了解这些规则,然后底层实现则有Compiler / Runtime根据不同平台去实现
Java                                                Go                                                Python
 │                                                   │                                                   │
 ▼                                                   ▼                                                   ▼
synchronized / volatile / AtomicInteger             sync.Mutex / sync/atomic / channel                 threading.Lock / queue.Queue
 │                                                   │                                                   │
 ▼                                                   ▼                                                   ▼
Java Memory Model                                   Go Memory Model                                     CPython Concurrency Semantics
 │                                                   │                                                   │
 └───────────────────────────────────────────────────┼───────────────────────────────────────────────────┘
                                                     │
                                       Compiler / Runtime 实现
                                       屏蔽不同硬件平台的差异
                                                     │
                                            ┌────────┴────────┐
                                            │                 │
                                            ▼                 ▼
                                         x86-64             ARM64
2. 程序员需要怎么了解内存模型的规则?
其实就是通过这三个方面来了解:
- Atomicity
- Visibility
- Ordering
理论上,每个并发工具类,在内存模型层都有相应的规则,说明这个工具类都满足了以上的某几个特性。
这一篇不深入,而是用之前的例子:
count++以及:
counter = 1
ready = true
从语言内存模型层的规则来证明:
| 问题 | 具体来说 |
|---|---|
| Atomicity | count++ 为什么不是原子的? |
| Visibility | A 写入 counter = 1 后,B 为啥不一定能看到 counter =1 ? |
| Ordering | 当 B 看到 ready = true 时,为什么不一定能看到前面的 counter = 1? |
2.1 Java Memory Model
Atomicity
假设进程中有一个变量:
count = 0现在有两个执行单元:
Thread A                    Thread B

count++                     count++
如果 A 和 B 各执行一次,最终结果是否一定是:
count = 2答案是不一定。
因为 count++ 可以从逻辑上拆成三个步骤:
读取 count
计算 count + 1
写回 count
于是可能出现:
初始:count = 0

Thread A                    Thread B

读取 count -> 0
计算 count + 1 -> 1
                            读取 count -> 0
                            计算 count + 1 -> 1
写入 count -> 1
                            写入 count -> 1
最终:
count = 1两个线程都完成了一次 +1,但因为它们读取到了相同的旧值 0,最终两次计算结果都只是 1,其中一次更新被覆盖了。
因此普通的 count++ 不能被视为原子的。
Visibility
再看:
int counter = 0;

// Thread A
counter = 1;

// Thread B
System.out.println(counter);
即:
Thread A                    Thread B

counter = 1                 read counter
在 Java 里,Visibility 一般通过 happens-before 关系来说明:一个写操作是否能保证被另一个线程看到,关键就是看两者之间是否建立了 happens-before 关系。
JLS §17.4.5 对 happens-before 有一个非常直接的描述:
“If one action happens-before another, then the first is visible to and ordered before the second.”
也就是说,如果能够建立:
Thread A                    Thread B

counter = 1                 read counter
     │                           ▲
     │                           │
     └──── happens-before ───────┘
那么 Thread A 的写入被保证对 Thread B 的读取可见。
而现在这段代码中:
Thread A                    Thread B

counter = 1                 read counter
     │                           ▲
     │                           │
     └── no happens-before ──────┘
没有建立这样的跨线程 happens-before 关系。
因此Thread B 不一定能看到 1
Ordering
再回到第二个例子:
// Thread A
counter = 1;
ready = true;

// Thread B
if (ready) {
    System.out.println(counter);
}
即:
Thread A                    Thread B

counter = 1
ready = true                read ready == true
                                  │
                                  ▼
                             read counter
在 Java 里,Ordering 也可以通过 happens-before 来描述:如果一个操作 happens-before 另一个操作,那么前一个操作,以及在同一线程中先于它发生的内存写入,都会通过 happens-before 的传递性排在后一个操作之前;这些写入也会对后一个操作以及其后的读取可见。
套回这个例子:在 Thread A 内部,counter = 1 先于 ready = true;在 Thread B 内部,读取 ready 又先于读取 counter。但两个线程之间,还缺少从 ready = true 到 read ready == true 的跨线程 happens-before 关系。
因此,当前代码中 Thread A 和 Thread B 之间仍然没有建立完整的 happens-before 保证:
Thread A                    Thread B

counter = 1
ready = true                read ready == true
     │                            │
     │                            ▼
     │                       read counter
     │
     └──── no cross-thread happens-before
因此,B即使观察到:
ready == true也不一定能看到
counter == 12.2 Go Memory Model
Atomicity
在 Go 里,Atomicity 可以直接从 Go Memory Model 对 Data Race 的定义切入:它先说明什么并发访问会构成 Data Race,再把 sync/atomic 提供的原子访问排除在这个定义之外。
Go Memory Model 原文:
“Programs that modify data being simultaneously accessed by multiple goroutines must serialize such access.”
随后它进一步说明,可以通过 channel、sync 和 sync/atomic 等同步机制来串行化这类访问;在 Data Race 的定义中,sync/atomic 提供的原子访问被明确排除在外。
而:
counter++只是普通的增量操作,并不是 sync/atomic 提供的原子访问。
因此,两个 Goroutine 并发执行:
counter++会对同一个 counter 产生并发读写,构成 Data Race。
所以普通的 counter++ 不能被视为原子的并发更新。
Visibility
继续看:
var counter int

// Goroutine A
counter = 1

// Goroutine B
fmt.Println(counter)
拆成两列:
Goroutine A                 Goroutine B

counter = 1                 read counter
在 Go 里,Visibility 也可以通过 happens-before 来描述。Go Memory Model 对普通读取 r 的可见性要求是:它读取到的写 w 必须对 r visible,其中第一个条件就是:
“w happens before r.”
套回我们的例子,如果能够建立:
Goroutine A                 Goroutine B

counter = 1                 read counter
     │                           ▲
     │                           │
     └──── happens-before ───────┘
那么这个写入可以被后面的读取可靠观察到。
而当前代码中:
Goroutine A                 Goroutine B

counter = 1                 read counter
     │                           ▲
     │                           │
     └── no happens-before ──────┘
两个 Goroutine 之间没有建立这样的关系,并且存在 Data Race。
因此不能依赖第二个 Goroutine 一定看到:
counter == 1Ordering
再看:
// Goroutine A
counter = 1
ready = true

// Goroutine B
if ready {
    fmt.Println(counter)
}
拆成双列:
Goroutine A                 Goroutine B

counter = 1
ready = true                read ready == true
                                  │
                                  ▼
                             read counter
在 Go 里,Ordering 同样可以通过 happens-before 来描述。这个例子和 Go Memory Model 在 Incorrect synchronization 中给出的例子本质上相同:一个 Goroutine 先写数据,再写一个标志;另一个 Goroutine 观察到标志以后,再读取前面的数据。
Go Memory Model 原文:
“Even if this occurs, it does not imply that reads happening after r will observe writes that happened before w.”
套回我们的例子:
Goroutine A                 Goroutine B

counter = 1
ready = true                read ready == true
                                  │
                                  ▼
                             read counter

        没有 happens-before 保证
所以:
看到 ready == true并不能推出:
一定看到 counter == 1这一点和 Java 的例子非常接近。
Java 和 Go 都使用 happens-before 来描述重要的Visibility和Ordering。
2.3 CPython 的并发语义
Python 和 Java、Go 有一个重要区别:
Python 没有一套适用于所有解释器实现、与 JMM 或 Go Memory Model 同等级的统一并发内存模型。
因此这里讨论最常用的实现:CPython。
仍然使用同样的两个例子:
counter += 1以及:
counter = 1
ready = True
来看 Atomicity、Visibility 和 Ordering。
2.3.1 GIL 模式
在继续讨论 counter 之前,我们先弄清楚:
GIL 到底保护了什么?
GIL 首先是 CPython Runtime 用来保护 Python 对象和解释器内部状态的机制。
Python 官方 C API 文档对 GIL 的要求说得很直接:
“only a thread that holds the GIL may operate on Python objects or invoke Python’s C API.”
也就是说,在默认的 GIL-enabled CPython 中,线程必须先持有 GIL,才能操作 Python 对象或调用 Python C API。
官方文档紧接着用 Reference Count 说明为什么需要这把锁:如果两个线程同时增加同一个对象的引用计数,最终可能只增加一次,而不是两次。
假设某个 Python 对象当前:
refcount = 10如果两个线程可以同时修改这个引用计数:
Thread A                    Thread B

read refcount = 10          read refcount = 10

refcount + 1                refcount + 1

write refcount = 11         write refcount = 11
两个线程都增加了一次引用,但最终:
expected: refcount = 12
actual:   refcount = 11
这会破坏 CPython 对 Python 对象生命周期的管理。
因此 GIL 首先保护的是:
             GIL
              │
              ▼
      CPython Runtime
              │
      ┌───────┴────────┐
      ▼                ▼
Python Objects     Runtime State
      │
      ├── Reference Count
      └── Object Internals
这里需要区分两个层面:
- CPython Runtime 层面:如何并发安全地访问和维护 Python 对象
- 应用程序层面:如何并发安全地访问和修改共享状态
GIL 主要解决前者,并不等价于应用程序自动获得线程安全。
Atomicity
现在回到:
counter += 1Python 官方 FAQ 对这一类操作有直接说明。
在讨论 GIL-enabled CPython 中哪些操作具有原子性时,官方明确把:
i = i + 1列为非原子操作:
“These aren’t:
i = i+1”
因此,即使存在 GIL,也不能把:
counter += 1视为一个整体原子的并发更新。
这里需要区分:
GIL
 │
 └── CPython Runtime / Python Object 的保护

counter += 1
 │
 └── 应用程序定义的一次复合状态更新
Visibility
继续使用同样的例子:
counter = 0

# Thread A
counter = 1

# Thread B
print(counter)
拆成双列:
Thread A                    Thread B

counter = 1                 read counter
到了这里,CPython 和 Java / Go 的区别就出现了。
Java 和 Go 可以继续问:
write
 │
 │ happens-before ?
 ▼
read
因为它们有正式定义的 Memory Model。
但是 Python 没有一套对应的、适用于所有 Python 实现的 happens-before 规则。
所以不能把上面的 CPython 代码画成:
Thread A                    Thread B

counter = 1                 read counter
     │                           ▲
     │                           │
     └──── Python happens-before ┘
然后引用某条 Python Language Memory Model 得出结论——因为不存在这样一套对应的正式模型。
但也可以反向说明,他没有单独说明这种规则说明的话,那我们就应该把这种操作看作是不确定的,既然不确定,那就是不满足 Visibility 的
Ordering
最后看:
# Thread A
counter = 1
ready = True

# Thread B
if ready:
    print(counter)
同样拆成:
Thread A                    Thread B

counter = 1
ready = True                read ready == True
                                  │
                                  ▼
                             read counter
同样,这里没有对应的规则说明,那我们就应该把这种操作看作是不确定的,既然不确定,那就是不满足 Ordering 的
2.3.2 Free-threaded 模式
从 Python 3.13 开始,CPython 提供可以禁用 GIL 的 Free-threaded 构建。
GIL-enabled CPython 中:
Thread A ──┐
           │
           ├── GIL ───> Python Code
           │
Thread B ──┘
而在 Free-threaded CPython 中:
Thread A ─────────────> CPU Core 0

Thread B ─────────────> CPU Core 1
多个线程可以真正并行执行 Python 代码。
但是,去掉 GIL 并不意味着 CPython 不再需要保护自己的对象和 Runtime 状态。
Python 官方的 Free-threading 文档明确说明,dict、list、set 等内置类型会使用内部锁来保护并发修改:
“Built-in types like
dict,list, andsetuse internal locks”
这些内部锁属于 Free-threaded CPython 的实现机制,不应被理解成 Python 语言层定义了一套统一的 Memory Model。
因此变化的是:
GIL-enabled

一把全局的 GIL
      │
      ▼
保护 CPython Runtime
变成:
Free-threaded

更细粒度的内部同步
      │
      ▼
保护 CPython Runtime
对于应用程序来说,前面的三个问题仍然存在
殊途同归。去掉 GIL 之后,CPython 并不是不再需要同步,而是从一把全局锁,走向更细粒度的锁、原子操作和 Runtime 协调;在这一点上,它最终也越来越接近 Java 和 Go 的实现思路。
2.3.3 那Python程序应该依赖什么?
综上,Java、Go 和 CPython 在这一层存在一个重要区别:
Java
  │
  ▼
Java Memory Model
  │
  └── happens-before

Go
  │
  ▼
Go Memory Model
  │
  └── happens-before

Python
  │
  ▼
不同 Interpreter 的并发语义
  │
  └── CPython
        ├── GIL-enabled
        └── Free-threaded
总结就是一句话:Python 没有一套适用于所有解释器实现、与 JMM 或 Go Memory Model 同等级的统一 Memory Model。因此,在 Python 中讨论并发安全,需要先明确使用的是哪一种 Interpreter,并依赖明确的同步工具及其提供的并发保证。
3. 下一篇:互斥锁
上边讨论了硬件层面,这一篇讨论语言内存模型的规则解释
下一篇开始讨论第一个具体同步工具:Mutex,从语言内存模型层一直追到硬件层
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看