
并发编程(零):并发问题与讨论范围
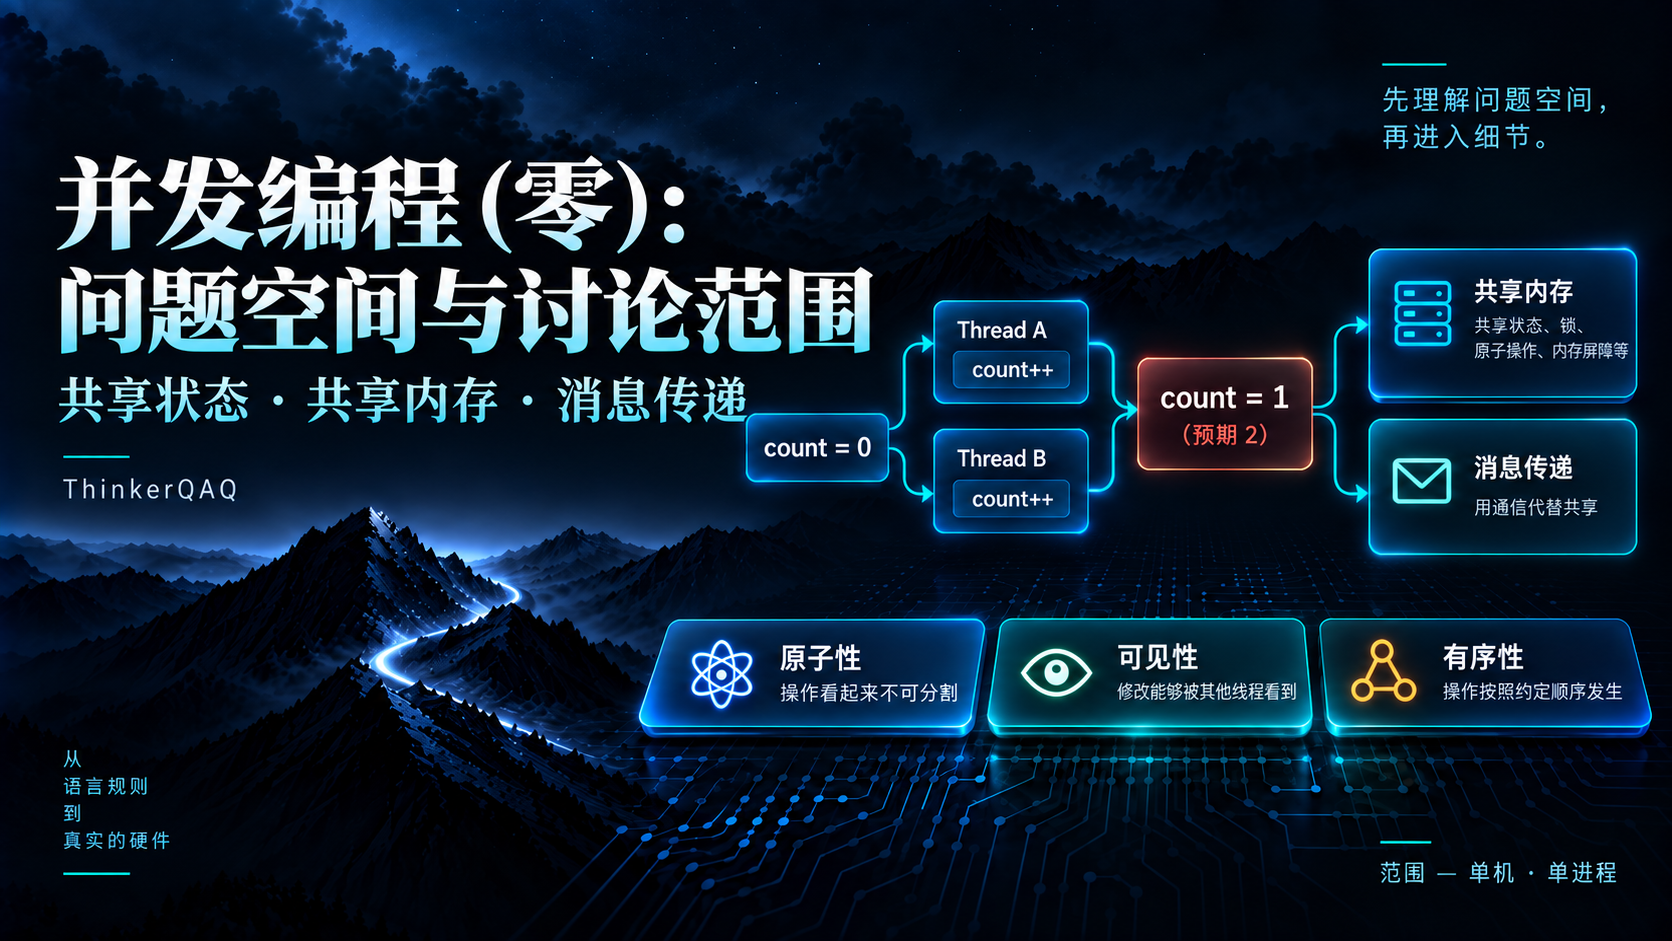
限定单机、单进程范围,从共享变量出发,建立共享内存、消息传递、语言并发语义与硬件实现之间的整体关系。
目录
- 1. 先明确讨论范围
- 2. 从一个共享变量开始
- 3. 两种主要的协作模型
- 4. 为什么这些代码能够正确工作?
- 5. 语言需要定义并发语义
- 6. 为什么还要继续下钻到硬件?
- 7. 用一张图总结一下这个系列的讨论层次
- 8. 下一篇:先谈硬件
1. 先明确讨论范围
这个系列只讨论:
单机、单进程内部的并发。
也就是说,我们关注的是同一个进程中的多个执行单元。
例如:
- Java Thread;
- Go Goroutine;
- Python Thread / asyncio Task。
不讨论跨进程通信、分布式系统和网络通信。
2. 从一个共享变量开始
假设进程中有一个变量:
count = 0现在有两个执行单元:
Thread A                    Thread B

count++                     count++
如果 A 和 B 各执行一次,最终结果是否一定是:
count = 2答案是不一定。
因为 count++ 可以从逻辑上拆成三个步骤:
读取 count
计算 count + 1
写回 count
于是可能出现:
初始:count = 0

Thread A                    Thread B

读取 count -> 0
计算 count + 1 -> 1
                            读取 count -> 0
                            计算 count + 1 -> 1
写入 count -> 1
                            写入 count -> 1
最终:
count = 1两个线程都完成了一次 +1,但因为它们读取到了相同的旧值 0,最终两次计算结果都只是 1,其中一次更新被覆盖了。
问题的关键在于两个 Thread 同时修改了 count,也就是:
多个执行单元同时访问并修改了同一份可变数据。
在单机、单进程范围内,为保证该场景下的并发安全,主要有两种模型:
- Shared Memory:多个执行单元直接共享可变数据,通过锁、原子操作等同步机制协调并发访问;
- Message Passing:多个执行单元之间尽量避免直接共享可变数据,通过消息交换数据。
下面仍然以 count++ 为例,看这两种模型如何处理前面的并发问题。
3. 两种主要的协作模型
3.1 Shared Memory
仍然以 count 为例。
Java 中可以通过同步保护这段共享状态,例如 synchronized:
class Counter {
    private int count = 0;

    public synchronized void increment() {
        count++;
    }
}
两个线程仍然访问同一个 Counter:
Thread A                    Thread B

counter.increment()         counter.increment()
但是,由于 synchronized 的作用,两个线程不能同时进入 increment() 的临界区,也就是 count++。
假设 Thread A 先获得锁,完整的执行过程会变成:
初始:count = 0

Thread A                         Thread B

请求进入 increment()
获得锁
                                 请求进入 increment()
                                 无法获得同一把锁,等待
读取 count      -> 0
计算 count + 1  -> 1
写回 count      -> 1
退出临界区并释放锁
                                 获得锁
                                 读取 count      -> 1
                                 计算 count + 1  -> 2
                                 写回 count      -> 2
                                 退出临界区并释放锁

最终:count = 2
如果 Thread B 先获得锁,A 和 B 的顺序会互换,但结果仍然是 2。
所以,这里的关键不在于谁先执行,而在于一次一个线程退出临界区之前,另一个线程不能进入同一个临界区。因此,原来两个线程都读取到 0 的交错不会再出现。
Go 和 Python 中也有类似的方式,例如:
Go      -> Mutex
Python  -> Lock
它们的共同思路都是:
可变数据直接共享,但对该数据的访问需要通过锁、原子操作等同步机制进行协调。
3.2 Message Passing
仍然以 count 为例。
例如 Go:
increments := make(chan int)

go func() { // Counter Owner Goroutine
    count := 0

    for delta := range increments {
        count += delta
    }
}()
两个生产者 Goroutine 都不直接修改 count,而是把增量发送到同一个 Channel:
go func() { // Goroutine A
    increments <- 1
}()

go func() { // Goroutine B
    increments <- 1
}()
可以抽象成:
Goroutine A ── +1 ──┐
                     ├──> Channel ──> Counter Owner Goroutine ──> count++
Goroutine B ── +1 ──┘
两个 Goroutine 都只发送消息,真正的 count 由独立的 Counter Owner Goroutine 修改。
Java 和 Python 中也有类似的消息传递工具:
- Java
BlockingQueue - Python
queue.Queue/asyncio.Queue
它们的共同思路是:
多个执行单元通过消息协作,而不是同时直接修改同一份状态。
4. 为什么这些代码能够正确工作?
到这里,我们已经用两种方式处理了最开始的 count++ 问题。
Shared Memory 中,我们使用了同步机制:
synchronized / Lock / MutexMessage Passing 中,我们使用了:
Channel / Queue但还有一个更基础的问题:
为什么这些代码能够正确工作?
要回答这个问题,我们需要从并发程序最基本的三个维度来讨论:
- Atomicity(原子性):一个执行单元执行一个或多个操作时,这些操作对其他执行单元是否表现为一个不可分割的整体;其他执行单元看不到中间状态,只能看到操作前或操作后的状态。
- Visibility(可见性):一个执行单元写入数据后,其他执行单元是否能够观察到该写入。
- Ordering(有序性):一个执行单元按先后顺序执行多个操作时,其他执行单元观察到这些操作生效的顺序,是否符合原本的先后关系。
程序员需要知道,在这三个维度上究竟可以依赖哪些保证。
这就需要继续引出:
语言提供的并发语义。
5. 语言需要定义并发语义
编程语言需要定义:
多个执行单元同时访问并修改了同一份可变数据时,程序允许出现哪些行为,程序员又可以依赖哪些规则。
Java 有:
Java Memory ModelGo 有:
Go Memory ModelPython 的情况比较特殊,本系列主要结合:
Python / CPython Concurrency Semantics来讨论。
这些规则需要回答三个问题:
| 问题 | 回到 count 例子意味着什么 |
|---|---|
| Atomicity | count++ 包含“读取 → 加一 → 写回”。不加锁时,A 和 B 的步骤可能交错;使用同一把锁后,这段临界区对其他使用同一把锁的执行单元表现为不可交错。 |
| Visibility | A 写回 count = 1 并释放锁后,B 随后获得同一把锁时必须能够看到这个写入,而不能继续使用旧值 0。 |
| Ordering | A 写入 count = 1 后释放锁,B 随后获得同一把锁并读取 count;同步规则需要保证 B 观察到的这些操作符合这个先后关系。 |
6. 为什么还要继续下钻到操作系统和硬件?
语言定义并发规则,这些规则最终落实到操作系统和真实机器上。
Operating System 负责管理程序真正运行时的执行单元,例如 Thread 的调度、等待和唤醒,以及 Semaphore、Futex、Condition Variable 等同步机制。
Hardware 则提供更底层的执行基础,例如 Atomic Instruction、Memory Ordering,以及 CPU Cache、Store Buffer 等实现机制。
7. 用一张图总结一下这个系列的讨论层次
先看正常的软件到硬件分层,可以简化为下面这条链:
Source Code
├──→ Java:Java / JDK Source
├──→ Go:Go / Standard Library Source
└──→ Python:Python / Standard Library Source
        ↓
Compiler / Translator
├──→ Java:javac
├──→ Go:Go Compiler
└──→ Python:CPython Compiler
        ↓
Runtime / Execution Environment
├──→ Java:HotSpot JVM(Interpreter / JIT / Runtime)
├──→ Go:Go Runtime
└──→ Python:CPython Interpreter / Runtime
        ↓
Operating System
└──→ Linux / Windows / macOS
        ↓
Hardware
        │
        ├── ISA ──→ x86-64 / ARM64
        │      ↓
        ├── Microarchitecture ──→ Cache / Store Buffer / Reorder Buffer / Out-of-Order Execution
        │      ↓
        └── Physical Hardware ──→ CPU / DRAM / Interconnect
Language Memory Model / Concurrency Semantics 是一组跨层约束:Compiler、Runtime、Operating System 和 Hardware 的实现,共同满足语言对程序员定义的并发规则。
这个系列聚焦并发。为了让后面的 Mutex、Atomic、Volatile 等文章都沿着同一套结构向下展开,这里把并发规则和上面的正常软硬件分层合并成一张讨论图:
Concurrency Tools
├──→ Java:synchronized / Lock / Atomic / BlockingQueue
├──→ Go:Mutex / Atomic / Channel
└──→ Python:Lock / Queue / asyncio
        ↓
Language Memory Model / Concurrency Semantics
├──→ Java:Java Memory Model
├──→ Go:Go Memory Model
└──→ Python:Python / CPython Concurrency Semantics
        ↓
Runtime / Language Implementation
├──→ Java:HotSpot JVM(Interpreter / JIT / Runtime)
├──→ Go:Go Runtime
└──→ Python:CPython Interpreter / Runtime
        ↓
Operating System
└──→ Thread / Scheduler / Semaphore / Futex / Condition Variable
        ↓
Hardware
├──→ ISA:x86-64 / ARM64
├──→ Microarchitecture:Cache / Store Buffer / Reorder Buffer / Out-of-Order Execution
└──→ Physical Hardware:CPU / DRAM / Interconnect
8. 下一篇:先谈硬件
下一篇正式进入硬件:
主要讨论:
- CPU 为什么需要缓存;
- 多核 CPU 如何协调缓存数据;
- 写缓冲和乱序执行为什么会影响内存访问顺序;
- 原子指令提供什么能力;
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看