
并发编程(六):Atomic 的实现——从 Runtime 到 CPU
沿着 Java AtomicInteger、Go sync/atomic 和 CPython 内部 Atomic 的真实实现路径,理解 Atomic RMW、CAS、内存顺序以及它与 Mutex 的区别。
目录
- 0. 这一篇继续回答什么?
- 1. HotSpot 如何实现 AtomicInteger?
- 2. Go Runtime 如何实现 sync/atomic?
- 3. CPython 如何实现内部 Atomic?
- 4. 三种实现的共同套路
- 5. 下一篇:volatile
0. 这一篇继续回答什么?
上一篇从语言内存模型的规则出发,看 Atomic 如何提供 Atomicity、Visibility 和 Ordering。
这一篇继续往下看:Java、Go 和 CPython 分别如何在 Runtime 和 CPU 层实现这些保证。
1. HotSpot 如何实现 AtomicInteger?
1.1 分层
先把 Java 的实现层次固定下来:
Java Source Code
实例:AtomicInteger.incrementAndGet() / compareAndSet() / get()
作用:声明 Atomic 操作
        │
        ▼
JVM Bytecode
实例:invokevirtual AtomicInteger.incrementAndGet() / compareAndSet() / get()
作用:调用 AtomicInteger 方法;没有 Atomic 专用字节码
        │
        ▼
JVM Implementation(HotSpot)
实例:Intrinsic / C1 / C2
作用:把 Atomic 操作降低到目标架构
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
1.2 一次 AtomicInteger 的完整实现路径
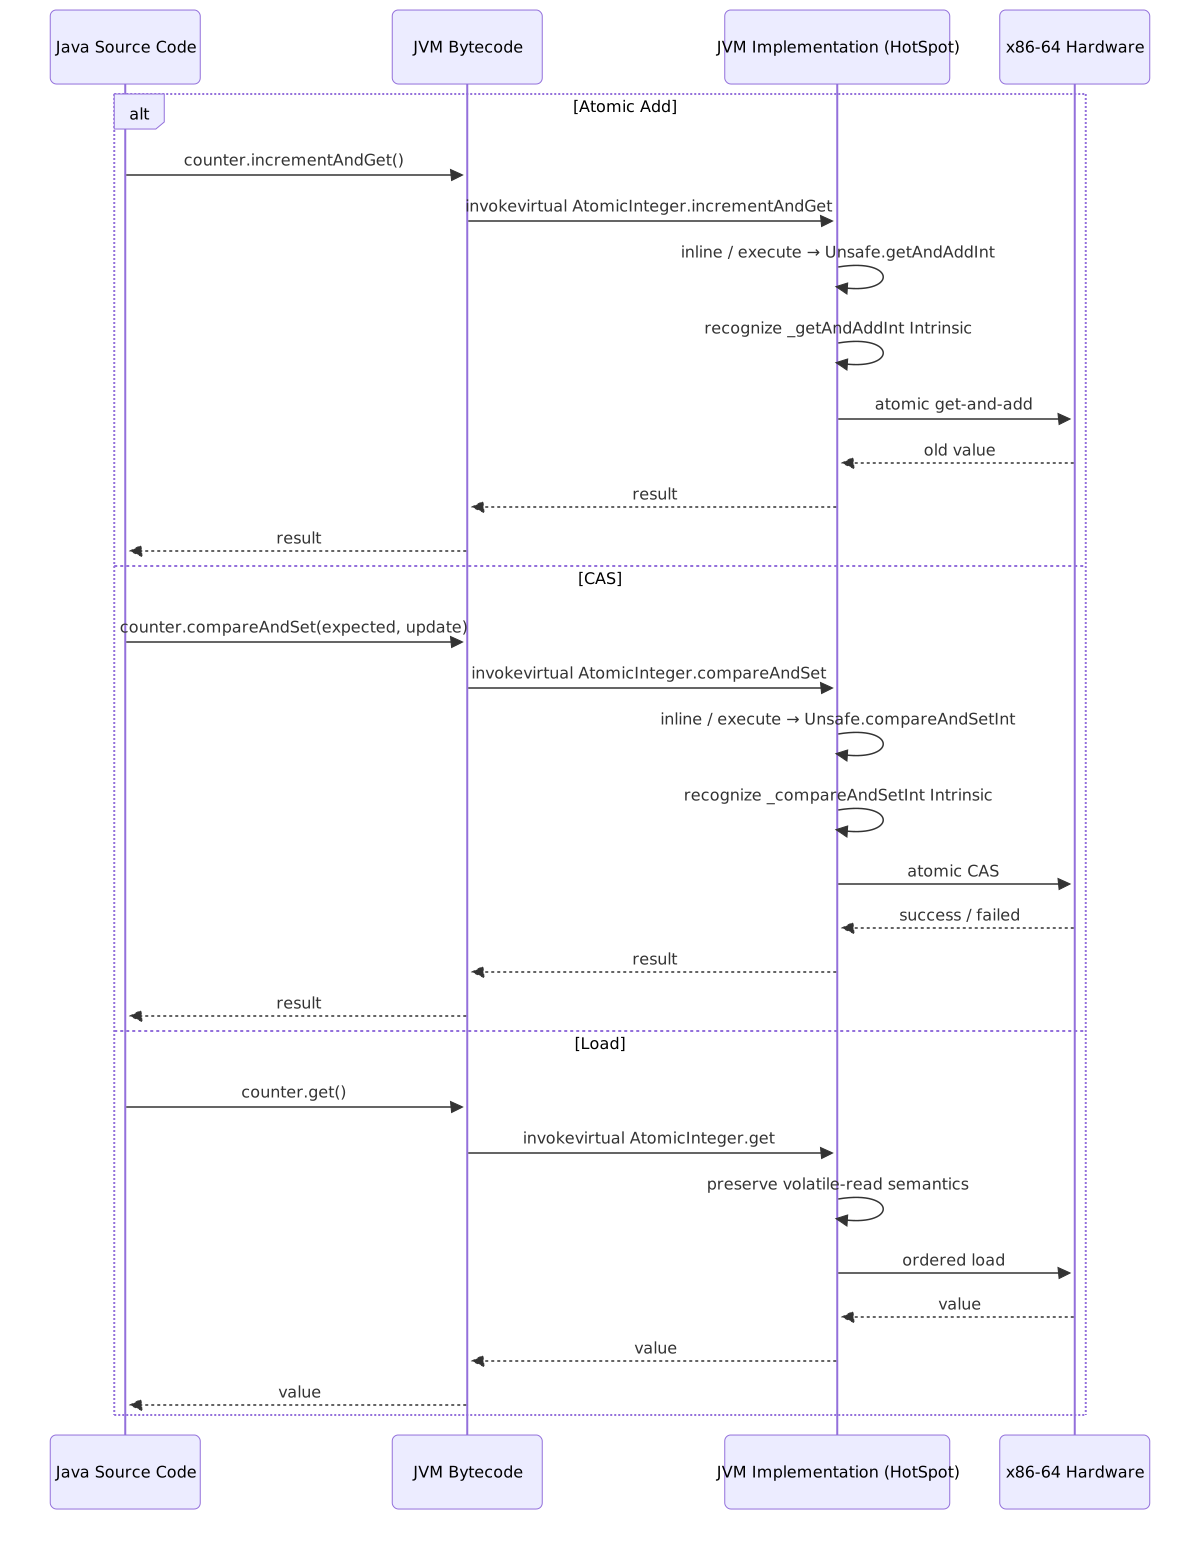
上面的时序图只保留跨层主流程。HotSpot 内部的核心路径可以进一步展开为:

1.3 Runtime / Language Implementation 层的三种保证
1.3.1 Atomicity
Atomicity 对应 HotSpot 对两类 Atomic 操作的实现:
Atomic Add
  → Unsafe.getAndAddInt
  → HotSpot Intrinsic / C1 / C2
  → Atomic Get-And-Add

CAS
  → Unsafe.compareAndSetInt
  → HotSpot Intrinsic / C1 / C2
  → Atomic CAS
在 Runtime / Language Implementation 层,这些操作已经被保留为不可分割的 Atomic RMW;再继续向下,才由目标架构提供具体的原子指令。
1.3.2 Visibility 和 Ordering
Visibility 和 Ordering 对应 HotSpot 对这些 Memory Effects 的保留:
写侧:Atomic Add / CAS
读侧:volatile read
上层的 JMM / VarHandle Memory Effects 规定这些操作的内存语义,HotSpot 在编译和优化过程中必须保留相应的顺序约束。
1.4 Hardware 层的三种保证
继续向下,这些保证再由 CPU 的 Cache Coherence 和内存顺序落实。
所以 Java 与第一篇的硬件模型对应为:
Atomicity
  → Atomic Instruction
  → HotSpot / x86-64: LOCK XADD / LOCK CMPXCHG

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Fence / 等价顺序约束
  → x86-64 memory ordering + LOCKed RMW / Load rules
实现可以继续查看 OpenJDK 的 AtomicInteger.java、Unsafe.java、vmIntrinsics.hpp、c1_GraphBuilder.cpp 和 c2compiler.cpp。
2. Go Runtime 如何实现 sync/atomic?
2.1 分层
Go Source Code
实例:atomic.Int64.Add() / CompareAndSwap() / Load()
作用:声明 Atomic 操作
        │
        ▼
Go Implementation
实例:sync/atomic + internal/runtime/atomic
作用:实现 Atomic API 与底层 Atomic Primitive
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
2.2 一次 atomic.Int64 的完整实现路径
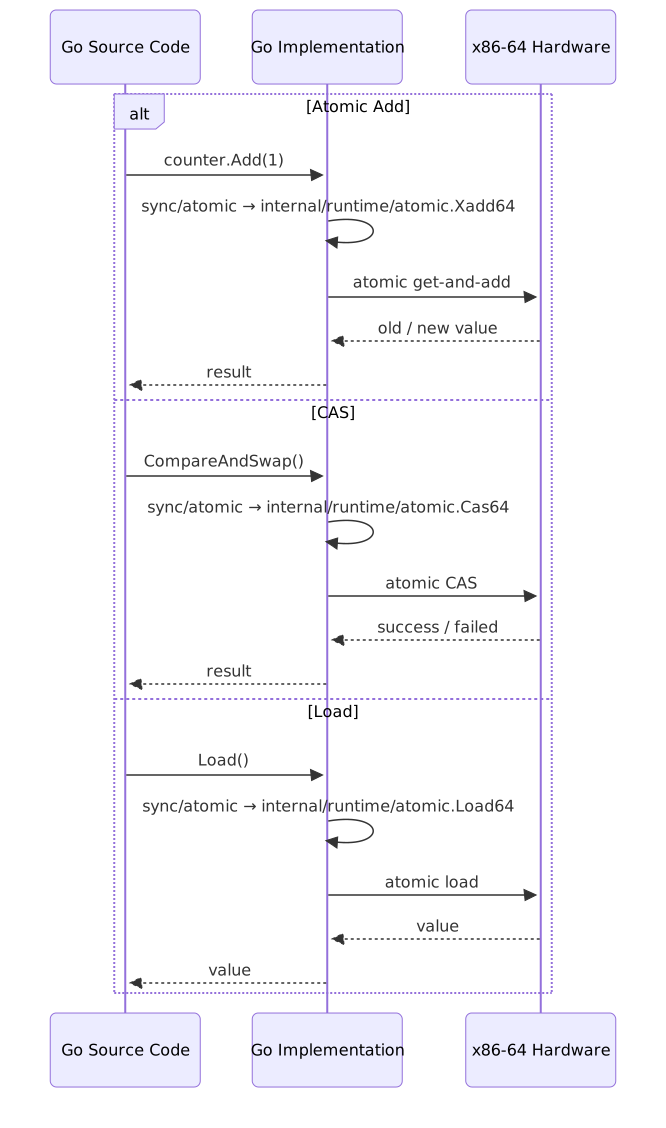
上面的时序图只保留跨层主流程。Go 内部的核心路径可以进一步展开为:

2.3 Runtime / Language Implementation 层的三种保证
2.3.1 Atomicity
Atomicity 对应 Go Implementation 中的 Atomic Primitive:
Atomic Add
  → sync/atomic
  → internal/runtime/atomic.Xadd64

CAS
  → sync/atomic
  → internal/runtime/atomic.Cas64
在 Runtime / Language Implementation 层,Add 和 CAS 已经具有不可分割的 Atomic 语义;目标架构再负责提供具体的原子指令。
2.3.2 Visibility 和 Ordering
Visibility 和 Ordering 对应 Go Implementation 对 Atomic 语义的保留:
写侧:Xadd64 / Cas64
读侧:Load64
Go Memory Model 规定 Atomic 操作的同步与顺序语义,编译器和 Runtime 必须把这些语义保留下来。
2.4 Hardware 层的三种保证
继续向下,这些保证再由 CPU 的 Cache Coherence 和内存顺序落实。
所以 Go 与第一篇的硬件模型对应为:
Atomicity
  → Atomic Instruction
  → Go / x86-64: LOCK XADDQ / LOCK CMPXCHGQ

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Fence / 等价顺序约束
  → x86-64 memory ordering + LOCKed RMW / Load rules
实现可以继续查看 sync/atomic/type.go、sync/atomic/asm.s 和 internal/runtime/atomic/atomic_amd64.s。
3. CPython 如何实现内部 Atomic?
Python 标准库没有与 AtomicInteger、atomic.Int64 对称的通用整数 Atomic API,所以这一节从 CPython Runtime 内部开始。
3.1 分层
CPython Runtime Source Code
实例:Runtime 内部共享状态更新
作用:调用内部 Atomic 操作
        │
        ▼
CPython Implementation
实例:_Py_atomic_* + GCC / Clang __atomic_*
作用:实现 Atomic 与 Memory Order,并降低到目标架构
        │
        ▼
x86-64 Hardware
实例:Atomic Instruction / Cache Coherence / Fence
作用:提供 Atomicity、Visibility 与 Ordering 的硬件基础
3.2 一次 CPython Atomic 的完整实现路径
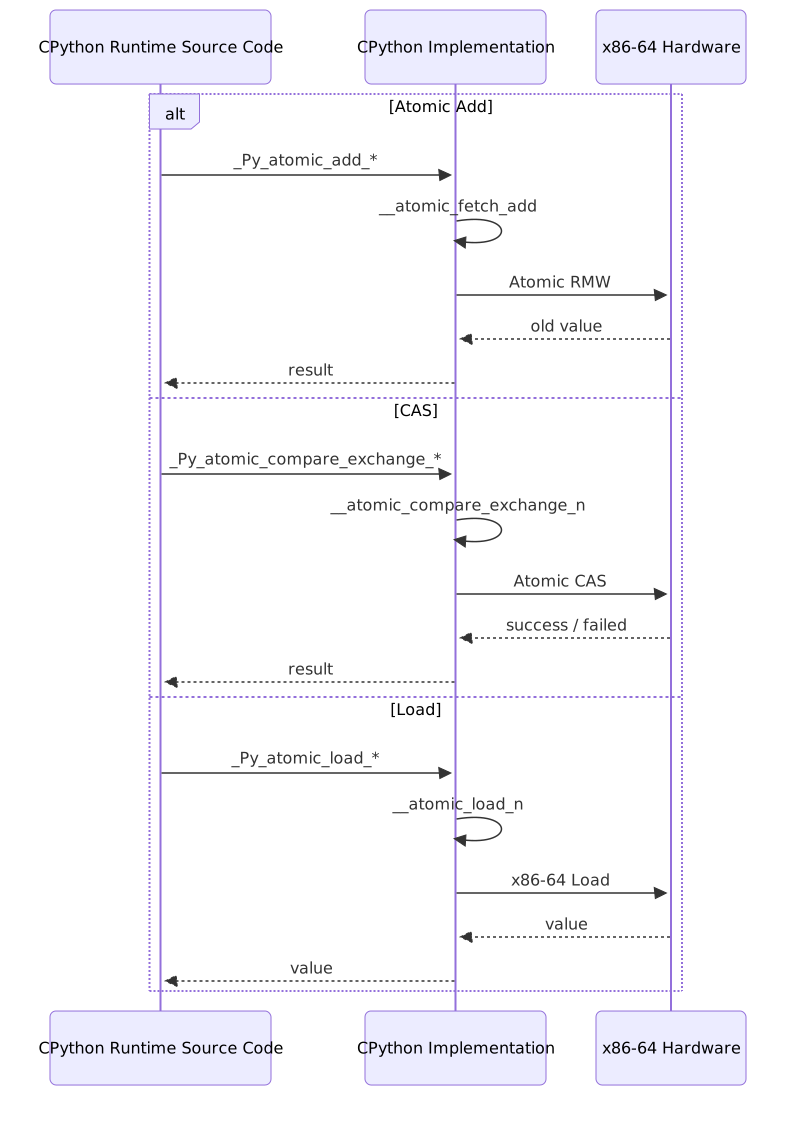
上面的时序图只保留跨层主流程。CPython 内部的核心路径可以进一步展开为:

3.3 Runtime / Language Implementation 层的三种保证
3.3.1 Atomicity
Atomicity 对应 CPython Implementation 对内部 Atomic 操作的表达:
Atomic Add
  → _Py_atomic_add_*
  → __atomic_fetch_add

CAS
  → _Py_atomic_compare_exchange_*
  → __atomic_compare_exchange_n
在 Runtime / Language Implementation 层,这些操作携带明确的 Atomic 语义;具体使用哪条机器指令,由编译器和目标架构继续落实。
3.3.2 Visibility 和 Ordering
Visibility 和 Ordering 对应上面流程图里的 Atomic 写入与读取边界:
写侧:Atomic Add / CAS
读侧:Atomic Load
_Py_atomic_* 将 Memory Order 传递给 GCC / Clang 的 __atomic_* builtins,并在实现层保留对应的顺序语义。
3.4 Hardware 层的三种保证
继续向下,编译器再把这些 Atomic 与 Memory Order 映射到目标架构。
所以 CPython 与第一篇的硬件模型对应为:
Atomicity
  → Atomic Instruction
  → x86-64: LOCK XADD / LOCK CMPXCHG

Visibility
  → Cache Coherence
  → 典型 x86-64 CPU:MESI-family(如 MESIF / MOESI)

Ordering
  → Fence / 等价顺序约束
  → x86-64 ordering rules + compiler-selected instruction sequence
这里描述的是 CPython Runtime 的实现,不把它提升成 Python 应用层的 Memory Model。
实现可以继续查看 pyatomic.h 和 pyatomic_gcc.h。
4. 三种实现的共同套路
看完 Java、Go 和 CPython,把具体 API 拿掉,Atomic 做的事情其实很固定。
4.1 一次更新怎么做到不可分割?
普通的 read-modify-write 是三步:
Load
  ↓
Modify
  ↓
Store
问题是其他执行单元可以插进来:
CPU A                       CPU B

Load 0                      Load 0
Add 1                       Add 1
Store 1                     Store 1
Atomic 做的事情就是把这三步收成一次操作:
Atomic RMW
   │
   ├── Add
   ├── Swap
   └── CAS
继续往下,最终由 CPU 的原子指令完成。
4.2 同时更新冲突了怎么办?
如果是 Atomic Add,两次更新都要完成:
counter = 0

CPU A                       CPU B

Atomic Add
0 → 1

                            Atomic Add
                            1 → 2
先后顺序可以不同,但不会丢掉其中一次更新。
如果是 CAS,情况不同:
CPU A                       CPU B

CAS 0 → 1                  CAS 0 → 1
    │                           │
    ▼                           ▼
  success                     failed
CAS 失败以后,上层代码决定怎么办:
CAS
 │
 ├── success ──> done
 │
 └── failed
       │
       ├── return false
       │
       └── reload → retry
所以 Atomic 没有 Mutex 那条固定的 Spin → Park → Wakeup 路径。Add 直接完成一次原子更新;CAS 失败则返回失败,是否重试由上层决定。
4.3 为什么还能保证 Visibility 和 Ordering?
Atomicity 只保证“这一笔更新不能被拆开”。
Atomic 前后的普通读写还要满足上层规定的内存顺序:
前面的普通写入
      │
      ▼
Atomic Update
      │
      ▼
Atomic Read
      │
      ▼
后面的普通读取
这条关系继续往下由三层保证:
Language / Runtime Memory Semantics
        ↓
Compiler Ordering
        ↓
Hardware Memory Ordering + Cache Coherence
所以三种实现虽然 API 不同,最终都在解决同三件事:
一次更新不可分割
        +
冲突时怎么处理
        +
前后的内存访问不能乱
4.4 Atomic 和 Mutex 有什么区别?
最简单的区别只有一句:
Atomic 处理一次共享状态操作;Mutex 保护一段代码。
4.4.1 一次状态更新,两种做法
比如只想把一个计数器加一。
Mutex:
Lock
  ↓
counter++
  ↓
Unlock
Atomic:
Atomic Add(counter, 1)Mutex 的思路是:
先让一个执行单元进入
        ↓
再执行这段代码
        ↓
最后退出
Atomic 的思路是:
这一次更新本身
直接不可分割
如果问题真的只有一次 Add、CAS、Swap 或 Load / Store,Atomic 不需要再包一层临界区。
4.4.2 多个 Atomic 为什么不能代替一把 Mutex?
假设一次操作要同时改两个状态:
balance -= 100
count++
把两个变量分别做成 Atomic:
Atomic balance -= 100
        ↓
        ← 其他线程可能在这里读到中间状态
        ↓
Atomic count++
只能保证两次更新各自不可分割,不能保证它们合起来也是一个整体。
Mutex 可以直接把两步包起来:
Lock
  ↓
balance -= 100
count++
  ↓
Unlock
在这段临界区结束以前,其他竞争者不能进入同一段受保护代码。
所以问题一旦从“改一个状态”变成“这几步必须一起完成”,Mutex 就更容易表达。
4.4.3 怎么选?
直接看你要保护什么:
一次状态操作
Add / CAS / Swap / Load / Store
        ↓
Atomic一段逻辑
读取 → 判断 → 修改多个状态
↓
Mutex两者也不是完全独立的。
Mutex 自己在实现“谁先拿到锁”时,底层通常就会使用 Atomic / CAS:
Atomic / CAS
    ↓
竞争锁状态
    ↓
Mutex
    ↓
保护临界区
所以可以把关系理解成:
Atomic:解决一次共享状态更新
Mutex:在 Atomic 等底层能力之上,再提供一整段临界区
5. 下一篇:volatile
Atomic 解决的是 counter++ 这类 RMW 的原子更新。
如果不需要 RMW,只需要让一个线程的写入对另一个线程可见,并建立正确顺序,就进入了 volatile 的问题。
下一篇继续从语言规则开始讨论 Visibility 和 Ordering。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看