并发编程(十一):Shared Memory 与 Message Passing——关系与组合使用
从消息交接的底层实现和任务处理的实际场景出发,理解共享内存与消息传递的关系,以及两种协作模型如何组合使用。
目录
0. 从上一篇继续
前面的文章已经分别讨论了 Shared Memory 和 Message Passing 两种并发协作模型。
接下来,我们讨论它们的关系,以及面对具体的并发需求时,如何选择与组合使用。
1. 两种协作模型是什么关系?
Shared Memory 通过直接访问共享状态进行协作,Message Passing 则通过发送和接收消息进行协作。两者的协作方式不同,却并不互斥。
上一篇分析 BlockingQueue 和 Channel 时已经看到:Producer 和 Consumer 虽然通过消息交换数据,通信组件内部仍然需要通过共享内存维护队列状态。
以 Java ArrayBlockingQueue 为例:
Producer
    |
    v
ArrayBlockingQueue
    |
    +-- Array:存放消息
    |
    +-- ReentrantLock:保护队列状态
    |
    +-- Condition:队列为空或已满时等待
    |
    v
Consumer
多个 Producer 和 Consumer 可能同时入队或出队,因此 ArrayBlockingQueue 使用锁保护队列操作,并通过 Condition 协调队列空、满时的等待与唤醒。
Go Channel 通过 Runtime 的 hchan 管理缓冲区和等待队列,并使用锁、原子操作及 Goroutine 调度机制协调通信;CPython 的 queue.Queue 则使用 Mutex 和 Condition 保护队列状态。
Message Passing 没有消除底层的共享状态,而是将消息交接所需的同步封装在 Channel、Queue 等通信组件中。 这也是为什么上一篇最终仍要回到 Mutex、Atomic、Condition 和内存顺序,解释消息交接如何满足 Atomicity、Visibility 和 Ordering。
2. 两种模型如何组合使用?
在实际程序中,两种模型经常一起使用。
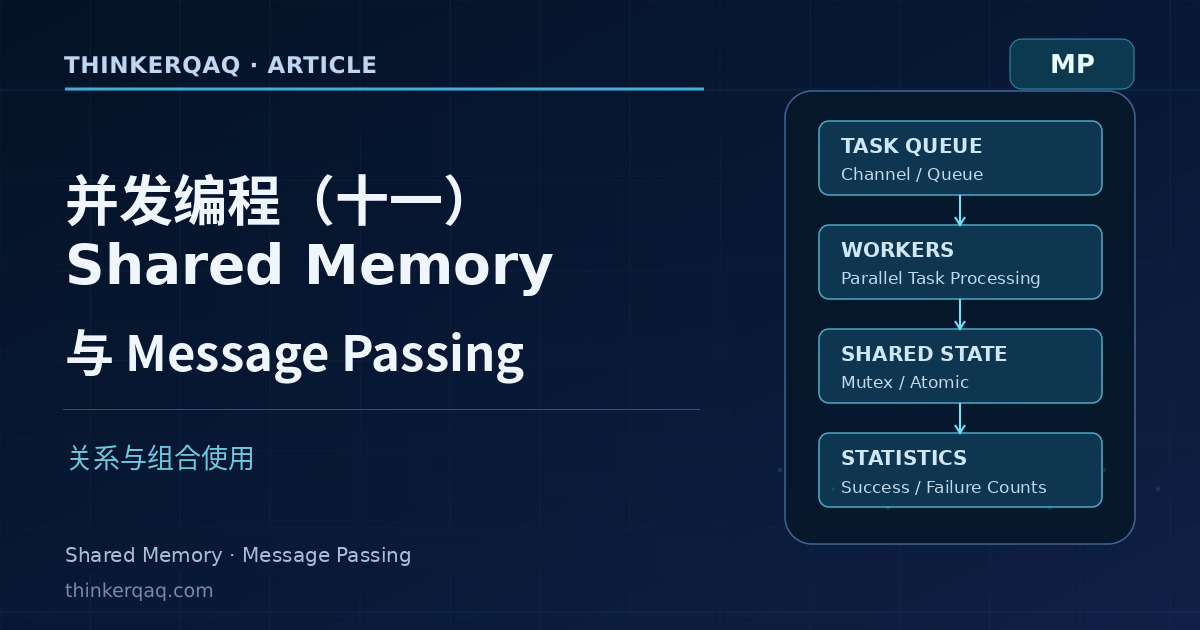
例如,一个任务处理系统需要由多个 Producer 提交任务、多个 Worker 并行执行,并统计成功和失败的任务数量:
Producer A ──┐
             ├──> Task Queue ──> Worker 1 ──┐
Producer B ──┘                └─> Worker 2 ──┤
                                            |
                                            v
                                     Shared Statistics
(Mutex / Atomic)这里,Message Passing 负责任务交接:Producer 将任务放入 Queue,Worker 取出并处理;Shared Memory 负责统计状态的更新:多个 Worker 通过 Mutex 或 Atomic 协调对统计数据的访问。
如果希望统计状态由一个执行单元集中维护,也可以让 Worker 发送处理结果:
Producer --> Task Queue --> Workers
                               |
                               v
                          Result Queue
                               |
                               v
                          Stats Owner
                               |
                               v
                           Statistics
这时只有 Stats Owner 修改统计数据,Worker 不再直接访问它。
两种方案都能保证正确性,但各有代价:直接更新共享状态更简单;由 Owner 集中处理,便于统一维护多个字段及其约束,却增加了消息交接和 Owner 的生命周期管理,也可能形成串行瓶颈。
3. 小结
本篇从底层实现和实际应用两个角度,讨论了 Shared Memory 与 Message Passing 的关系,以及如何组合使用这两种协作模型。
下一篇进入本系列的终章。我们将回顾整个并发编程系列,并最后做个总结。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看