并发编程(十二):终章——系列总结
回顾从 count++ 出发的并发正确性问题、Shared Memory 与 Message Passing 两条主线,以及从并发工具到底层硬件的五层知识体系。
目录
1. 回顾整个系列的核心脉络
一切始于第零篇的一个简单例子:多个执行单元同时执行 count++,最终结果是否一定符合预期?
由此,我们引出了并发正确性的三个基本维度:Atomicity、Visibility 和 Ordering,并以此作为贯穿整个系列的分析基础。
围绕单机、单进程内多个执行单元之间的协作,我们选择了两条主线:
| Shared Memory | Message Passing | |
|---|---|---|
| 协作方式 | 直接访问共享状态 | 通过消息交接进行协作 |
| 主要工具 | Mutex、Atomic、volatile、ReadWriteLock | BlockingQueue、Channel、queue.Queue |
| 关注重点 | 共享状态的同步访问 | 消息交接与执行协调 |
第三篇至第八篇首先沿着 Shared Memory 展开,从 Mutex、Atomic 到 volatile、ReadWriteLock,梳理了这些同步机制的语言规则与底层实现。
第九篇和第十篇转向 Message Passing,从消息传递的发展历史和通信语义出发,进一步分析 BlockingQueue、Channel 和 queue.Queue 的内部实现。
第十一篇则将两条主线联系起来,讨论它们之间的关系,以及在实际程序中如何组合使用。
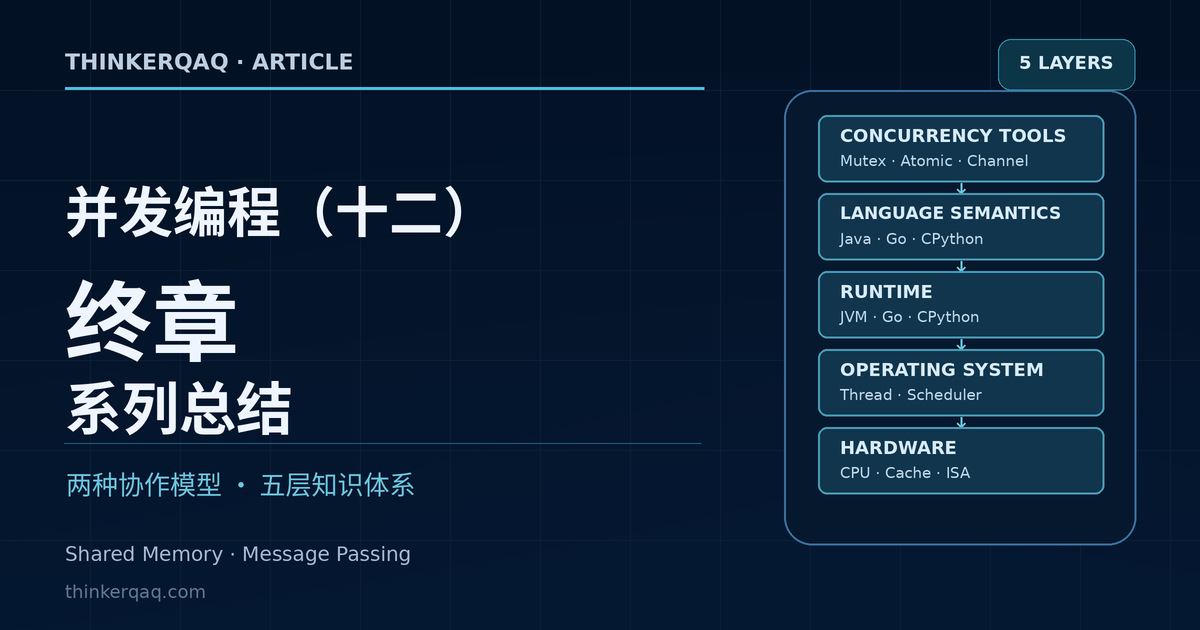
回到第零篇提出的分层图,整个系列讨论的协作模型、语言规则与底层实现,都可以串联在这五个层次之中:
Concurrency Tools
├──→ Java:synchronized / Lock / Atomic / BlockingQueue
├──→ Go:Mutex / Atomic / Channel
└──→ Python:Lock / Queue / asyncio
        ↓
Language Memory Model / Concurrency Semantics
├──→ Java:Java Memory Model
├──→ Go:Go Memory Model
└──→ Python:Python / CPython Concurrency Semantics
        ↓
Runtime / Language Implementation
├──→ Java:HotSpot JVM(Interpreter / JIT / Runtime)
├──→ Go:Go Runtime
└──→ Python:CPython Interpreter / Runtime
        ↓
Operating System
└──→ Thread / Scheduler / Semaphore / Futex / Condition Variable
        ↓
Hardware
├──→ ISA:x86-64 / ARM64
├──→ Microarchitecture:Cache / Store Buffer / Reorder Buffer / Out-of-Order Execution
└──→ Physical Hardware:CPU / DRAM / Interconnect
2. 结语
至此,并发编程系列全部结束。
希望这个系列留下的不只是具体并发工具的用法,更是一套能够将并发协作模型、语言规则与底层实现联系起来的知识体系。
讨论
使用 GitHub 账号参与讨论,评论会保存在 GitHub Issues 中。在 GitHub 查看